训练模型:沿着损失地图往下走
梯度下降、学习率、初始化与反向传播。
现在我们有了一族模型(第 3 篇),也有了衡量其中任一成员错得多厉害的损失(第 4 篇)。训练就是找到损失最低的参数,也就是损失地图上的最低点。对房价直线,我们可以画出整张地图,直接读出答案;但一个有数百万个参数的网络,它的地图谁也画不出来。本文介绍梯度下降:它只看自己当前所在位置的坡度,就能找到低处。之后我们讨论可能出现的问题,以及怎样为神经网络计算坡度。
1. 在房价直线上做梯度下降
设想一个人在大雾中走在图 4.2 的损失地图上。他看不见最低点在哪里,却能感觉到脚下的地面朝哪个方向倾斜。梯度下降的做法也是如此:朝下坡方向迈一小步,重新测量坡度,如此反复。
坡度用导数来衡量。导数 表示:保持 不变、让 增加一个极小的量时,损失变化得有多快; 对 表示同样的意思。对直线 的均方误差,导数为:
两者都是第 4 篇中误差的和。第二个导数用输入 给每个误差加权,因为改变斜率时,直线在 大的地方移动得比在 小的地方多。两个导数合起来构成梯度,它指向损失增加最快的方向。梯度下降朝相反方向移动:
箭头表示“替换为”。正数 (读作“alpha”)是学习率,它决定每一步迈多大。用文字说:计算坡度,朝下坡迈一小步,然后重复。
我们从一个很差的猜测 、 出发,它的损失是 。由式 5.1 算出两个导数为 和 。两者都是负数,所以增大任何一个参数都会降低损失。取 ,由式 5.2 得到:
只走一步,损失就从 降到 。图 5.1 画出了前 1000 步的路径。
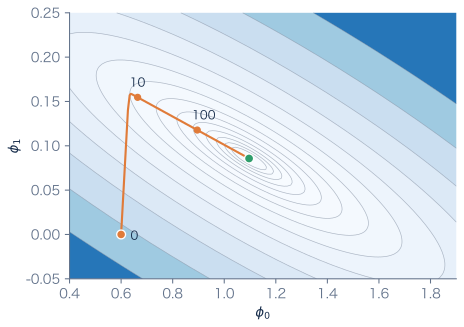
图 5.1 损失地图上的梯度下降。 橙色路径从 、(损失 0.839)出发,按学习率 执行式 5.2。图中的数字标出第 10 步(损失 0.0548)和第 100 步(损失 0.0123)时的参数。1000 步之后,路径到达最好的直线(绿色),损失为 0.00063。
这条路径分为两个阶段,两者都源于地图的形状。第一步主要改变的是 ,因为损失对斜率比对截距敏感得多:斜率要乘上最大为 9 的年份。这让路径很快进入山谷。谷底几乎是平的,导数很小,步子也就很小。从第 10 步走到谷底,用掉了 1000 步中的大部分。
2. 学习率
学习率在速度和稳定之间取舍。用一个只有一个参数的例子可以把这一点说得很精确。取损失 ,它的最低点在 ,导数为 。梯度下降走一步得到:
每走一步,到最低点的距离就乘以 。从 出发(图 5.2):
- 当 时,因子为 0.9。每一步只消除剩余距离的十分之一,走了 8 步, 才到 1.709。
- 当 时,因子为 0.4,8 步之后 。
- 当 时,因子为 。每一步都越过最低点跳到另一侧,而且落点比上一次稍远:,然后 ,然后 ,依此类推。训练发散了。
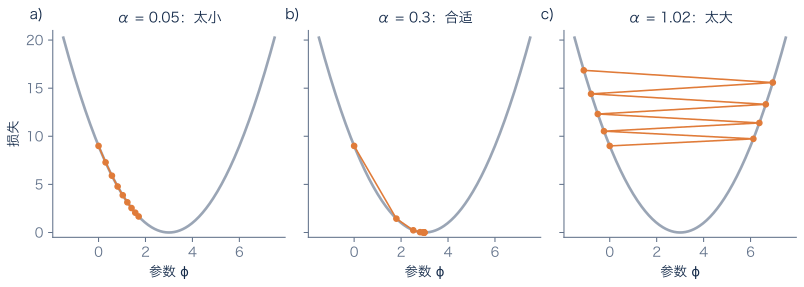
图 5.2 学习率。 在损失 上从 出发做 8 步梯度下降。a):步子稳妥但缓慢。b):参数很快到达最低点。c):每一步都冲过头,参数离最低点越来越远。
真实的损失地图没有这么简单,也没有公式能给出最好的学习率。实践中,人们会尝试几个取值,保留在验证集上表现最好的那个(第 6 篇)。
训练网络时也有同样的取舍。下面的实验训练一个有四个隐藏单元的网络,把中间的一簇点和外面的一圈点分开,学习率从 开始。
点击播放,观察输出图上方的训练损失。学习率为 0.003 时,损失下降得很慢:100 轮之后仍高于 0.3。 把 Learning rate 改成 0.03,再点击重置按钮(播放按钮左边的 ↺),重新开始训练。这一次,到第 100 轮损失已低于 0.06。 然后改成 10,再重置一次。几轮之内,损失就跳到比起点还高的位置,而且再也降不下来:和图 5.2c 一样,每一步都冲过头,网络最后卡在离好的拟合很远的地方。
3. 最低点难以到达的时候
梯度下降能找到直线损失地图的底部,因为那张地图只是一个碗。但一般情况下,仍有两类问题。
模型可能选得不好。 训练只能找到模型这一族所能达到的最低点。如果把直线换成一个每年都预测同一个价格的模型,它在房价数据上能达到的最好损失是 0.0612,约为直线 0.00063 的一百倍。没有哪种训练方法能解决这个问题,因为没有哪个常数能拟合上升的趋势。设计得不好的模型,最低点本身就很高。相反的问题,即模型灵活到连训练数据中的噪声都拟合了,是第 6 篇的主题。
地图可能有好几个山谷。 神经网络的损失地图不是一个碗。它可能有许多深浅不一的山谷,还有平坦的高原。梯度下降只会往下坡走,所以它会停在自己走进的那个山谷的谷底,这称为局部极小值。从哪里出发,决定了最终落在哪个山谷(图 5.3)。
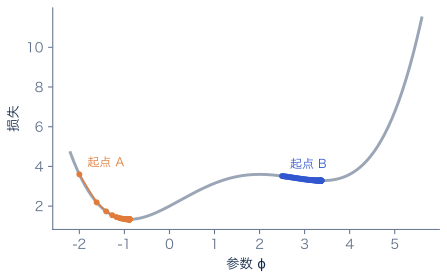
图 5.3 起点很重要。 一个有两个山谷的损失。从起点 A(,橙色)出发,梯度下降到达较深的山谷,停在 ,损失 1.333。从起点 B(,蓝色)出发,同样的算法停在较浅的山谷,位于 ,损失 3.282,因为从那里往任何方向走都是上坡。
起始参数是随机选取的,这一步称为初始化。在深层网络中,初始化除了决定训练落进哪个山谷,随机值的尺度也极其重要。如果初始权重太大,在网络中传递的数值会一层比一层大,直到溢出;如果太小,数值会逐层缩小到接近零。无论哪种情况,引导训练的导数都会失去作用,训练陷入停滞。标准的做法根据每个单元的输入个数来确定尺度。对 ReLU 网络,He 初始化[3] 从方差为 的分布中抽取每个权重,其中 是这个单元的输入个数。
图 5.3 这样的一维图像可能会夸大局部极小值的危险。在有数百万个参数的网络中,通常总还有某个方向是下坡,而且训练到达的许多山谷损失相近 [6]。训练失败更常见的原因是初始化不当和学习率不当,而不是不巧落进了坏山谷。
4. 为网络计算梯度
式 5.1 很容易推导,因为直线很简单。网络有很多层,每个参数都要经过它之后的每一层才能影响损失。高效计算所有导数的算法称为反向传播[2]。它就是系统地运用微积分中的链式法则:一个参数对损失的影响,等于它沿途各环节影响的乘积。
我们来看最小的情形:一个输入、一个使用 ReLU 的隐藏单元、一个输出:
其中 是单个训练样本的平方误差。取参数 、、、,样本 、。
前向传播从输入到损失依次计算各个值。预激活为 ,是正数,所以 。预测为 ,损失为 。
反向传播从损失往输入方向依次计算导数,每一步都复用上一步的结果:
- 损失对预测的依赖:。
- 输出层参数: 增加 1, 增加 1,所以 ; 增加 1, 增加 ,所以 。
- 隐藏单元: 每增加 1, 增加 ,所以 。
- 经过 ReLU:预激活为正,ReLU 让变化原样通过(斜率为 1),所以对预激活的导数也是 4。
- 第一层参数:,。
这里的每个导数都可以这样验证:把参数微调一个极小的量,重新计算损失。不论参数有多少个,反向传播都只需一次反向计算就能得到全部导数,开销与前向传播相当。深度学习库会自动完成这一过程,所以我们很少需要手工推导导数。
5. 在大数据集上训练
式 5.1 要对全部 个训练样本求和。如果有一百万张照片,每走一步都需要一百万次前向和反向计算。随机梯度下降(SGD)改为在训练数据的一个随机小子集上计算梯度,这个子集称为批或小批量,通常有 32 到 512 个样本,每处理一批就走一步。一批数据上的梯度是对完整梯度的带噪声的估计,但开销只有后者的极小一部分。完整地过一遍训练集称为一轮(epoch),训练通常要进行许多轮。
如今,改进版的 SGD 已成为标准做法。动量法让每一步部分地延续之前几步的方向,从而加快在图 5.1 那样的狭长山谷中的前进速度。Adam[5] 还为每个参数分别调整步长。
把这些部分组合起来,就得到几乎所有神经网络都在使用的训练循环(细节各有不同):
- 以合适的尺度随机初始化参数。
- 取一批训练样本。
- 前向传播:计算预测和损失。
- 反向传播:计算梯度。
- 用梯度下降或它的某个变体更新参数。
- 回到第 2 步重复;不时检查模型在验证集上的表现(第 6 篇),不再提升时停止。
小结
训练是在损失地图上寻找低处。梯度下降计算指向上坡方向的梯度,然后朝反方向迈一步,步长由学习率决定。学习率太小,训练缓慢;太大,训练来回跳动甚至发散。模型选得不好,最低点本身就高。梯度下降可能停在局部极小值;初始参数的尺度决定了深层网络能否训练起来。反向传播用链式法则高效地算出网络的全部导数,随机梯度下降则用小批量数据让每一步都很便宜。
注释
对输入重新缩放。 图 5.1 中的山谷又长又窄,是因为年份最大取到 9,而截距乘的是 1。如果从数据的中间开始计算年份,让它从 取到 ,山谷就会圆得多,梯度下降收敛所需的步数也会少得多。这就是训练前通常要把输入归一化到相近范围的原因。
鞍点。 在高维空间中,梯度为零的点往往是鞍点,即某些方向下坡、另一些方向上坡,而不是真正的局部极小值。梯度下降在鞍点附近会变慢,但通常能逃离 [6]。
初始化的研究。 Glorot 和 Bengio [4] 分析了在使用 sigmoid 和 tanh 激活的深层网络中,初始权重的尺度如何影响网络中传递的数值;He 等人 [3] 把这一分析推广到了 ReLU。
延伸阅读。 《Understanding Deep Learning》[1] 第 6、7 章讲解了梯度下降、SGD、动量、Adam、反向传播和初始化。
练习
练习 5.1 对损失 ,什么学习率能让任意起点都恰好一步到达最低点?(答案:,此时因子 为零。)
练习 5.2 在反向传播的例子中,如果样本改为 ,,五个导数分别是多少?(答案:预激活为 ,所以 ,,;于是 ,,两个 的导数都是 0,因为 ReLU 处于关闭状态。)
练习 5.3 一个训练集有 50,000 张图像,批大小为 100。一轮包含多少次参数更新?(答案:500。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: David Rumelhart, Geoffrey Hinton and Ronald Williams (1986). Learning representations by back-propagating errors. Nature 323, 533–536.
- 3: Kaiming He, Xiangyu Zhang, Shaoqing Ren and Jian Sun (2015). Delving deep into rectifiers: surpassing human-level performance on ImageNet classification. International Conference on Computer Vision.
- 4: Xavier Glorot and Yoshua Bengio (2010). Understanding the difficulty of training deep feedforward neural networks. International Conference on Artificial Intelligence and Statistics.
- 5: Diederik Kingma and Jimmy Ba (2015). Adam: a method for stochastic optimization. International Conference on Learning Representations.
- 6: Yann Dauphin, Razvan Pascanu, Caglar Gulcehre, Kyunghyun Cho, Surya Ganguli and Yoshua Bengio (2014). Identifying and attacking the saddle point problem in high-dimensional non-convex optimization. Advances in Neural Information Processing Systems 27.