模型评估:在新数据上还管用吗?
训练集、验证集与测试集,过拟合,以及常用评估指标。
第 5 篇找到了在训练数据上损失最低的参数,但这并不是我们真正想要的。我们想要的是一个对从未见过的输入也能做出好预测的模型:明年的房价、明天拍下的照片。本文说明为什么低训练损失不能保证这一点,怎样通过留出数据来诚实地衡量表现,以及常见任务用哪些数字来报告表现。
1. 完美拟合,预测却很糟
我们用三个模型拟合十年的房价:一个常数(每年都预测同一个价格),第 1 篇的直线,以及一个 9 次多项式,即一条有十个参数的曲线(图 6.1)。
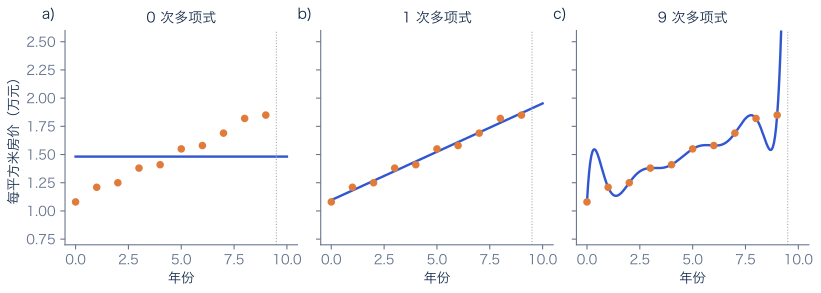
图 6.1 欠拟合与过拟合。 用第 0–9 年的房价拟合三个模型,竖直虚线标出数据的终点。a)常数:训练误差 0.0612,对第 10 年预测 1.48。b)直线:训练误差 0.00063,预测 1.95。c)9 次多项式:训练误差几乎为零,因为它穿过了每一个点,但它对第 10 年的预测是 22.47。
只看训练误差,9 次多项式是最好的模型:它精确地拟合了十个点。然而它对第 10 年的预测是当前房价的十多倍。十个参数足以让曲线恰好穿过十个点,所以这条曲线不仅拟合了趋势,也拟合了每年小幅的、不会重现的波动。这称为过拟合。常数模型的问题恰好相反:它太简单,连趋势都跟不上,这称为欠拟合。直线的灵活程度足以描述趋势,又不至于去拟合噪声。
模型在来自同一来源的新数据上的表现,称为它的泛化能力。训练误差不能可靠地反映泛化能力,所以我们需要别的衡量方法。
2. 训练集、验证集与测试集
解决办法是留出一部分数据。在训练之前,我们把手头的数据分成三份:
- 训练集用于拟合参数,如第 5 篇所述。
- 验证集用于做出训练本身不做的选择,例如多项式的次数、隐藏单元的个数或学习率。这些量称为超参数。我们对每个候选设置各训练一个模型,保留验证误差最低的那个设置。
- 测试集只在最后使用一次,用来估计最终模型在新数据上的表现。
常见的比例是 70/15/15 或 80/10/10,具体取决于数据量。图 6.2 说明了为什么需要验证集。随着多项式次数增加,训练误差一直下降,因为每多一个参数,曲线就多一分自由。验证误差起初下降,一旦模型开始拟合噪声,就急剧上升。这里验证误差最低的是 3 次多项式。
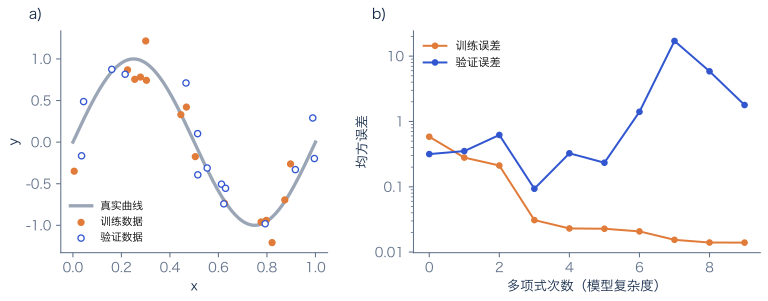
图 6.2 用验证集选择模型复杂度。 a)从同一条带噪声的波浪曲线(灰色)中取出的十五个训练点(橙色)和十五个验证点(蓝色)。b)用训练点拟合 0 到 9 次多项式。训练误差(橙色)随次数增加而下降。验证误差(蓝色,对数坐标)在 3 次时最低,次数更高时迅速增大,因为这些模型拟合了训练点中的噪声。
有些项目只把数据分成训练集和测试集,并用测试集来做选择。这样一来,测试误差就不再能衡量模型在未见数据上的表现,因为测试数据已经影响了模型。数据很少时,可以改用交叉验证:把数据分成比如五份,每份轮流充当一次验证集,用其余四份训练模型,再对五个验证误差取平均。
数据的划分方式还必须符合模型的用途。房价模型要预测的是未来,所以公平的测试应当留出最近的几年,而不是随机挑选。如果用第 0–7 年训练、用第 8 和第 9 年测试,直线的预测是 1.771 和 1.855,真实值是 1.82 和 1.85。精确拟合第 0–7 年的 7 次多项式则预测 8.26 和 47.85。
3. 绝不能用测试集训练
测试分数是一个承诺:它告诉读者,模型在从未见过的数据上会有怎样的表现。只有当测试数据完全没有参与模型的构建时,这个承诺才成立。如果测试数据被用于训练、用于选择超参数,甚至只是用来决定什么时候停止尝试新想法,分数都会偏高,有时偏高很多。把这样的分数当作诚实的估计发表,会误导所有依赖它的人,所以这被视为违反科研伦理的行为。
测试数据还可能以不那么明显的方式泄露进来:
- 重复样本。 相同或几乎相同的样本同时出现在训练集和测试集中,比如同一场景的两张照片。
- 预处理。 归一化之类的步骤使用了包含测试集在内的全部数据的统计量。这类统计量应当只用训练集计算。
- 时间。 模型本应预测未来,随机划分却把较晚的记录放进了训练集。
4. 基准
为了公平地比较各种方法,研究社区会约定一个基准:一个公开的数据集,固定地划分为训练、验证和测试数据,并规定衡量表现的方式。ImageNet [2] 是图像分类的经典基准,COCO [3] 是目标检测和分割的基准。论文在这些基准上报告结果,以便直接比较。“在基准 X 上达到最佳水平”说的就是这个意思。
基准有一个已知的弱点。当成千上万篇论文都在同一个测试集上调整方法时,即使没有哪一篇论文做错了什么,整个社区也可能对这个测试集过拟合。因此,有些基准对测试集的标签保密,由服务器为提交的结果打分。
5. 常用的评估指标
损失是为了让训练能够进行而选择的(第 4 篇)。报告结果时,我们使用人能理解的评估指标,它们取决于任务。
回归。 平均绝对误差(MAE)是误差大小的平均值,均方根误差(RMSE)是均方误差的平方根。两者的单位都与输出相同。用第 0–7 年训练、在第 8 和第 9 年测试的直线,误差为 和 ,所以 MAE 为 ,即每平方米 270 元。
分类。 最简单的指标是准确率,即预测正确的比例。当各类别数量不均衡时,它会产生误导:如果只有 2% 的照片里有猫,一个永远回答“没有猫”的模型准确率高达 98%,却毫无用处。混淆矩阵能给出更完整的图景。假设用 100 张照片测试一个猫检测器,其中 40 张有猫:
| 预测“有猫” | 预测“没有猫” | |
|---|---|---|
| 有猫 | 32(真正例) | 8(假负例) |
| 没有猫 | 6(假正例) | 54(真负例) |
- 准确率 。
- 精确率问的是:模型说“有猫”的照片中,真有猫的占多少?。
- 召回率问的是:真正有猫的照片中,模型找出了多少?。
- F1 分数综合二者:。
误报代价高时,精确率更重要,比如会把正常邮件藏起来的垃圾邮件过滤器;漏报代价高时,召回率更重要,比如医学筛查。
目标检测。 预测框只有与真实框重叠得足够多,才算正确。重叠程度用交并比(IoU)衡量:两个框共同覆盖的面积,除以两者合起来覆盖的面积。两个 的框,水平错开 20 个像素、竖直错开 10 个像素,共同覆盖的面积为 ,合起来覆盖 ,所以 IoU 为 。常见的规则要求 IoU 至少为 0.5,所以这个预测会被算作漏检。检测基准把各个置信度下的精确率和召回率汇总为平均精度均值(mAP),通常还会对多个 IoU 阈值取平均。
分割。 对每个类别,计算预测区域与真实像素区域之间的 IoU,再对类别取平均,得到平均交并比(mIoU)。与之密切相关的 Dice 系数在医学影像中很常用。
文本。 语言模型常用困惑度评估,它衡量模型认为一段留出的文本有多大概率出现。机器翻译和自动摘要传统上通过统计与参考文本共有的词序列来衡量,BLEU [4] 和 ROUGE [5] 就是这样做的。
| 任务 | 常用指标 |
|---|---|
| 回归 | MAE、RMSE |
| 分类 | 准确率、精确率、召回率、F1 |
| 目标检测 | IoU、mAP |
| 分割 | 平均交并比、Dice |
| 文本生成 | 困惑度、BLEU、ROUGE |
小结
低训练损失不能保证在新数据上做出好的预测:过于灵活的模型会拟合训练数据中的噪声,泛化能力很差。为了诚实地衡量表现,我们把数据分为三份:训练集用于拟合参数,验证集用于选择超参数,测试集只在最后使用一次。测试数据绝不能影响模型。基准固定了数据集、划分方式和指标,使不同方法可以相互比较。指标取决于任务:回归用 MAE 和 RMSE,分类用准确率、精确率、召回率和 F1,检测用 IoU 和 mAP。
课程的入门部分到此结束。掌握了模型、特征、网络、损失、训练和评估这六个概念,就能读懂大多数入门级的深度学习代码和论文。下一部分将在此基础上继续展开。
注释
偏差与方差。 图 6.1 中的两种失败常被描述为偏差(模型对真实关系而言过于简单所带来的误差)和方差(模型过于灵活,以至于依赖训练数据中特定噪声所带来的误差)。《Understanding Deep Learning》[1] 第 8 章分析了二者,还讨论了超大网络令人意外的双下降现象:当模型规模远远超过拟合训练数据所需时,测试误差可能再次下降。
正则化。 除了选择更简单的模型,减轻过拟合的方法还有:惩罚过大的参数值;在验证误差开始上升时提前停止训练;收集更多数据。《Understanding Deep Learning》[1] 第 9 章介绍了这些方法。
指标服务于决策。 没有哪个指标适合所有用途。筛查罕见病的模型和推荐电影的模型,需要在精确率和召回率之间做不同的取舍,而取舍应当依据每种错误的代价来决定。
练习
练习 6.1 沿用第 5 节的混淆矩阵。假设检测器经过修改后,对 50 张照片预测“有猫”,其中 38 张确实有猫。计算新的精确率和召回率。(答案:精确率 ,召回率 。)
练习 6.2 两个 的框在一块 的区域内重叠,它们的 IoU 是多少?(答案:。)
练习 6.3 一名学生尝试了 200 种不同的超参数设置,并报告了其中最好的测试准确率。解释为什么这个数字很可能高估了模型在新数据上的准确率。
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Jia Deng, Wei Dong, Richard Socher, Li-Jia Li, Kai Li and Li Fei-Fei (2009). ImageNet: a large-scale hierarchical image database. Conference on Computer Vision and Pattern Recognition.
- 3: Tsung-Yi Lin and colleagues (2014). Microsoft COCO: common objects in context. European Conference on Computer Vision.
- 4: Kishore Papineni, Salim Roukos, Todd Ward and Wei-Jing Zhu (2002). BLEU: a method for automatic evaluation of machine translation. Annual Meeting of the Association for Computational Linguistics.
- 5: Chin-Yew Lin (2004). ROUGE: a package for automatic evaluation of summaries. Text Summarization Branches Out.