深层网络:深度为什么有用
为什么叠加层数会让线性区域成倍增加,以及深度能带来什么、不能带来什么。
第 3 篇搭建了一个浅层网络,也就是只有一个隐藏层、由 ReLU 单元组成的网络,并说明它描述的是分段线性函数:每个隐藏单元增加一个拐点,单元足够多时,网络可以逼近任何连续函数。那篇文章最后说,叠加多层可以“经济得多”地产生拐点,这也是现代网络都很深的原因。本文把这句话说清楚。我们先手工复合两个小网络并数一数线性段,再说明这种复合是两个隐藏层网络的特例,接着用矩阵写出一般的深层网络,最后讨论深度能带来什么、不能带来什么:分别从能表示什么、能训练出什么、能否泛化三个方面来看。
第二部分默认读者已经掌握第一部分的内容:模型、损失、梯度下降、反向传播的基本思路以及过拟合;还默认读者熟悉矩阵乘法、转置和偏导数。新增的记号汇总在数学记号页面。
1. 复合两个网络
我们从两个与第 3 篇完全相同的浅层网络开始:一个输入,三个 ReLU 隐藏单元,一个输出。一般的深层网络留到第 3 节。第一个网络把 映射为 :
第二个网络形式相同,但有自己的参数:隐藏单元的参数记为 (读作“psi”),输出参数记为 。它把 映射为新的输出 :
复合这两个网络,就是把第一个网络的输出送进第二个网络:。两个网络本身都不变,我们只是把它们串联起来。
我们选一组让效果一目了然的参数。两个网络的三个隐藏单元位置相同: 时, 分别取 、、, 也取同样的值。因此三个单元分别在输入为 0、1、2 时开始激活。两个网络的输出权重不同:
| 输出偏移 | 输出权重 | |
|---|---|---|
| 网络 1, | ||
| 网络 2, |
我们只看 0 到 3 之间的输入。在这个范围内,网络 1 是一条锯齿线(图 7.1a)。在 0 到 1 之间只有单元 1 激活,所以 ,从 0 升到 3。在 1 到 2 之间单元 2 也激活了,斜率变为 , 从 3 降回 0。在 2 到 3 之间三个单元都激活,斜率为 , 又从 0 升到 3。也就是说,网络 1 把 、、 这三段区间各自映射到整个 上,中间一段方向相反。
网络 2 是同一范围上另一个由三段组成的函数(图 7.1b):0 到 1 之间斜率为 1,1 到 2 之间斜率为 ,2 到 3 之间斜率为 。
取 。在网络 1 中,三个预激活值是 、 和 ,所以隐藏单元的值是 、 和 ,。网络 2 的输入是 ,恰好得到同样的隐藏单元值,。
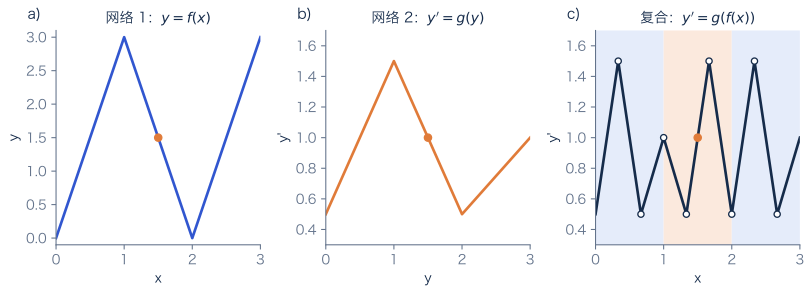
图 7.1 复合两个浅层网络。 a)按第 1 节参数设置的网络 1(式 7.1)在 上是由三段组成的锯齿线:它把输入范围的每个三分之一映射到整个 。b)网络 2(式 7.2)有三段,斜率分别为 1、 和 。c)复合函数 有九段。在每个着色的三分之一区间里,网络 2 的完整形状出现一次,横向压缩为原来的三分之一;在中间那段它左右翻转,因为 在那里是反向的。橙色点对应算例 。
图 7.1c 显示了结果。 从 0 走到 1 时, 扫过整个 ,所以 描出了网络 2 的完整函数。 从 1 走到 2 时, 反向再扫一遍, 描出网络 2 函数的镜像。 从 2 走到 3 时,又描一遍。每一份都保留了网络 2 的三段,所以复合函数共有 段线性部分,拐点位于 。
斜率可以验证这一点。根据链式法则, 的斜率等于 在 处的斜率乘以 在 处的斜率。在第一个九分之一区间里,两者都在上升:。在第二个九分之一区间里, 的斜率为 ,而 仍在上升:。九段的斜率依次是 ,相邻两段都不同,所以八个拐点都是真正的拐点。
这是本文的核心图景。网络 1 把输入范围折叠起来,像把一张纸折成三层叠在一起。网络 2 在折好的纸上画一个函数。把纸展开,每一层上都留下了这幅画。两个各有三个隐藏单元的网络产生了九段;而一个有六个隐藏单元的浅层网络最多只能产生七段,因为每个单元至多增加一个拐点。
2. 复合就是深层网络
第 1 节的复合,其实是一个有两个隐藏层的网络。为了看清这一点,我们把网络 1 的输出代入网络 2 的隐藏单元。网络 2 的第 个单元计算:
其中 是网络 1 的隐藏单元。第一行就是式 7.2 中的隐藏单元;第二行把式 7.1 代入 ;第三行合并同类项:不乘任何 的部分合成偏移,每个 的系数就是一个权重。
用文字说:第二组隐藏单元以第一组隐藏单元为输入,经过自己的偏移和权重。这正是第二个隐藏层。输出 再对 做加权求和,和任何网络一样。
代入我们的数值,从第一层单元 到第二层单元 的权重是 。由于每个 ,且 ,第二层的三个单元收到相同的权重;偏移为 :
这个矩阵结构特殊:每一行都是同一个向量 的倍数,所以它的秩为一。这就是“复合两个独立网络”带来的限制。一般的两隐藏层网络允许 的九个元素自由取值,因此它能表示任何两个三单元浅层网络的复合,还能表示许多别的函数。在一般网络中,第二层有 9 个自由权重和 3 个偏移,共 12 个数;而复合只用 10 个数(网络 1 的四个输出参数和网络 2 的六个隐藏单元参数)就决定了这 12 个数。因此复合共有 20 个参数,而各层大小为 1、3、3、1 的一般网络有 22 个(第 3 节会逐一数清)。
这也说明了第二层在一般情况下做什么。第一层的每个单元产生输入的一个分段线性函数。第二层的每个单元对这些函数做加权组合,结果仍是分段线性函数,再用 ReLU 在零处截断。截断一个多次穿过零的函数,会在每个穿越点产生一个新拐点。在第 1 节中,这个组合就是锯齿线 ,第二层的三个单元分别在高度 0、1、2 处把它截开。
3. 一般的深层网络
有 个隐藏层的网络依次计算向量 。每一层先对上一层的向量做仿射变换,再施加激活函数:
这个式子可以分成三部分。第一行把有 个元素的输入 映射为有 个元素的第一隐藏层 ,这就是第 3 篇隐藏层的矩阵写法。第二行对后面每一层重复同样的操作,以上一层的值为输入。最后一行是线性的,没有激活函数,这样输出可以取任意值;做分类时,第 4 篇的 softmax 在其后作为损失的一部分施加。用文字说:深层网络交替进行仿射变换和逐元素的激活,最后以一次仿射变换结束。
要把描述补充完整,还需写出形状。第 层有 个隐藏单元,并记输入大小 、输出大小 。于是:
- 是把第 层映射到第 层的权重矩阵。第 行第 列的元素,是从第 层单元 到第 层单元 的权重。
- 是第 层加上的偏置向量。
- 逐个作用于每个元素。除非另有说明,我们使用 ReLU。
这套记号与第 3 篇直接对应。浅层网络就是 的情形: 和 存放隐藏单元的偏移 和权重 , 和 存放输出偏移 和权重 。从现在起,我们用层的编号来区分参数,不再给每层一个单独的希腊字母。
每层有 个权重和 个偏置,所以整个网络有
个参数。第 2 节的网络各层大小为 ,参数数为 。一个识别 灰度手写数字图像的分类器,有两个 256 单元的隐藏层和 10 个输出,大小为 ,参数数为 。其中大部分在第一层,因为输入很大。
和 在训练前就固定下来,梯度下降不会改变它们。它们是超参数,像第 6 篇那样用验证集来选择。 是网络的深度, 是第 层的宽度。大多数全连接网络的所有隐藏层宽度相同,这时只需选两个数。
4. 数一数线性区域
使用 ReLU 激活时,式 7.4 形式的每个网络都计算一个分段线性函数:输入空间被分成若干区域,在每个区域内,输出是输入的仿射函数。数区域的个数,是衡量网络能做出多复杂函数的一种方法。本节分别为浅层和深层网络数一数。
浅层网络
区域来自隐藏单元的开与关。对一个固定的输入,每个 ReLU 单元要么激活(预激活为正,值原样通过),要么未激活(输出零)。如果固定哪些单元激活,每个 ReLU 就变成恒等函数或零,网络就成了输入的仿射函数。所以一个区域就是具有相同激活模式的输入的集合,拐点则是某个单元的预激活穿过零的地方。
一个输入、 个隐藏单元时,每个单元的预激活 只在一点穿过零,所以网络至多有 个拐点、 段。有 个输入时,单元 的零点集合 是一个超平面: 时是直线, 时是平面。处于一般位置的 个超平面把 维空间分成
个区域,这是几何学中的经典结果 [5]。其中 是从 个超平面中选出 个的方法数。一个输入时,这个和是 ,与前面一致。两个输入、三个隐藏单元时,它是 :处于一般位置的三条直线把平面分成七块。当 时,和等于 ,因为每种激活模式都可能出现。当 远大于 时,它的增长与 同阶:随宽度呈多项式增长。
深层网络
第 1 节暗示,深度会让区域数成倍增加。网络 1 把 折成三层。如果把它的输出再送进网络 1 的另一个副本,三层中的每一层都被再折一次,得到九段。第三个副本给出 27 段(图 7.2)。和第 2 节一样, 个副本串联起来就是一个有 个宽度为 3 的隐藏层的网络,各层大小为 。在 上,这个网络恰好有
段线性部分;由式 7.5,它有 个参数。
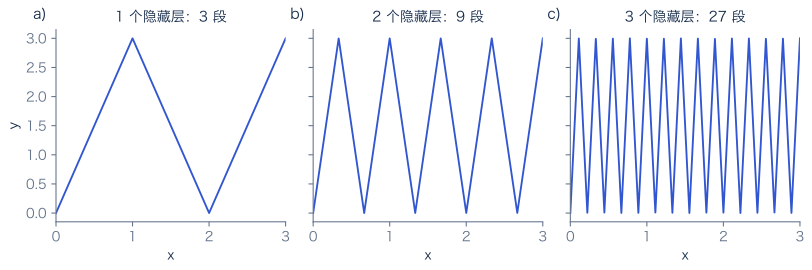
图 7.2 反复折叠。 把图 7.1a 的网络与自身复合。a)一个有三个单元的隐藏层:在 上有 3 段。b)两个隐藏层:9 段。c)三个隐藏层:27 段。每增加一个三单元的层,段数乘以三,参数增加 12 个。
参数数相同的浅层网络要差得多。一个输入时, 个隐藏单元有 个参数,所以 个参数只够 个单元,至多 段:
| 隐藏层数 | 参数数 | 深层网络:段数 | 参数相同的浅层网络:至多 |
|---|---|---|---|
| 1 | 10 | 3 | 4 |
| 2 | 22 | 9 | 8 |
| 3 | 34 | 27 | 12 |
| 4 | 46 | 81 | 16 |
| 5 | 58 | 243 | 20 |
深层网络的段数随参数数呈指数增长,浅层网络则是线性增长。这个构造可以推广:Montúfar 等人 [3] 构造了多输入的深层网络,其区域数随深度指数增长;而式 7.6 表明,浅层网络的区域数只随宽度多项式增长。这些都是关于最大值的结论:它们说的是存在某组参数能达到这个数目。
网络实际上算出了什么
典型网络的区域数并没有达到最大值。图 7.3 加入了第三条曲线:宽度为 8、深度为 1 到 8 的网络,权重像训练开始时那样随机抽取(He 初始化,见第 5 篇),偏置取很小的随机值。我们在输入范围 上数它们的段数,并对 30 次抽样取平均。深度为 1 的网络平均有 8.8 段,深度为 8、共 64 个隐藏单元的网络有 57.3 段。段数大致与隐藏单元数成正比,始终接近浅层网络的最大值 ,远远达不到 。
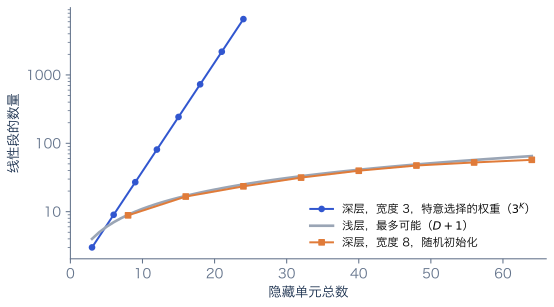
图 7.3 线性段数量的最大值与典型值(一个输入)。 蓝色:图 7.2 的折叠网络,宽度为 3、权重特意选择,用 个隐藏单元达到 段。灰色:有 个单元的浅层网络最多能产生的段数 。橙色:宽度为 8、深度为 1 到 8、权重随机初始化的深层网络,在 上 30 次抽样的平均段数。注意纵轴是对数刻度。随机的深层网络大约每个隐藏单元对应一段,远低于最大值。
这与 Hanin 和 Rolnick 的细致研究一致 [6]。他们证明,对按常规方式初始化的网络,输入空间中一条直线平均穿过的区域数由隐藏单元总数决定,大致与它成正比,而不随深度指数增长;他们还在实验中发现,训练过程中这个数目保持在同一量级。折叠构造需要精心调整权重,让每一折都恰好叠在其他折上;随机权重几乎不可能这样对齐。
5. 深度能带来什么,不能带来什么
现在有三个看似矛盾的事实。浅层网络已经是万能逼近器(第 3 篇),所以在单元数不限的情况下,深度并不能增加可表示的函数。深层网络在参数相同时能产生的段数可以比浅层网络多出指数倍。而典型的深层网络远远达不到这个最大值。本节把已知的结论理清楚,并把可表示性、可训练性和泛化分开讨论。
深度让某些函数的表示代价低得多。 这是定理,不是观察。Telgarsky [4] 证明:对每个正整数 ,存在一个函数,可以由层数约为 、每层单元数为常数的 ReLU 网络计算;而层数约为 的网络若要逼近它,至少需要约 个单元。这个函数是锯齿函数,机制与图 7.2 相同。Eldan 和 Shamir [7] 对一个多输入函数,证明了两个隐藏层与三个隐藏层之间也有类似的分离。这些结果说明深度可以带来指数级的效率。它们并没有说实践中需要的函数,例如从图像到类别的映射,属于这一类。这个问题仍未解决。
深度本身并不让训练更容易。 深层网络计算的函数是多层的复合,所以它的导数是许多因子的乘积(第 8 篇会推导)。许多因子相乘,结果往往变得极大或极小;没有特殊设计的深层网络,其损失曲面很难优化。He 等人观察到,在同一任务上,一个 56 层的普通网络比 20 层的网络训练误差更高 [8]。这不是过拟合,过拟合只会在留出数据上体现;更深的网络是连训练集都没拟合好。第 11 篇介绍的残差连接和归一化解决了这个问题,今天几百层的网络能够训练,靠的正是它们。
在实践中,深度往往有助于泛化,但原因并未完全弄清。 在图像、语音和文本任务上,一旦解决了上述训练难题,更深的网络一直比规模相近的浅层网络取得更低的测试误差。有一个实验把“表示”和“学习”分开了。Ba 和 Caruana [9] 训练浅层网络去模仿一个深层网络的输出,而不是原始标签,结果浅层网络的准确率接近了深层网络;而直接用标签训练的浅层网络做不到。浅层网络能够表示一个好的函数,只是用标签训练找不到它。所以深度的部分好处在于训练和泛化的效果,而不仅仅在于能表示什么。
简言之,深度有用,一是因为它能以低得多的代价表示某些函数,二是因为在合适的架构下,深层网络能训练出泛化良好的解。前者是关于特定函数的定理,后者是经验发现,只有部分理论支撑。
6. 批量计算:形状、运算量与内存
式 7.4 一次处理一个输入。训练时以及大多数部署场景中,网络一次处理一批 个输入(第 5 篇),计算变成一连串矩阵乘法。我们把输入作为矩阵 的各列。第一层计算:
其中 是由 个 1 组成的向量,所以 是一个 矩阵,每一列都是偏置向量。乘积 的形状是 :第 列是第 个样本的预激活。用文字说:同一组权重作用于每个样本,批这个维度只是跟着走。后面各层同理,得到 。
大多数深度学习库反过来存放一批数据,每个样本占一行,计算 。这只是同一计算的转置。我们保持每个样本占一列,与式 7.4 中的向量一致。
描述计算代价有三个量,不应混淆:
- 参数是训练会改变的数,与 无关。 分类器有 269,322 个参数,以 32 位浮点数存储约占 1.08 MB。
- 运算量。 一层把 矩阵乘以 矩阵,需要 次乘加。对这个分类器,每个样本需要 次乘加,一批 256 个样本约需 6880 万次。与矩阵乘法相比,加偏置和激活的开销可以忽略。第 8 篇会说明,反向传播的开销大约是这个的两倍。
- 激活值是中间结果 ,大小为 。训练时必须保留它们,直到反向传播用完为止(第 8 篇)。对大模型和大批量,占内存的主要往往是激活值,而不是参数。
全连接层让每个单元都依赖上一层的所有单元,输入很大时代价很高。一张 的彩色图像有 150,528 个输入值,一个 1000 单元的全连接层就需要约 1.5 亿个权重。卷积网络(第 10 篇)和 Transformer(第 12 篇)都是通过在层内共享权重来避免这一点的深层网络。
7. 术语
有了一般的网络,我们可以给各部分命名,并澄清一些含糊的用法。
- 由式 7.4 搭建的网络是深层全连接网络,也叫多层感知机(multilayer perceptron,MLP)。“深”没有确切的门槛,实践中指不止一个隐藏层。
- 深度 是隐藏层的个数,一层的宽度是它的隐藏单元数。论文中数层数的方式并不统一:有的数权重矩阵,把我们的 分类器称为“三层网络”;有的数隐藏层,称之为“两隐藏层网络”。使用时应说明是哪一种。
- 激活之前的值 是预激活,激活之后的值是激活值,与第 3 篇相同。
- 一个输入的激活模式是处于激活状态的 ReLU 单元的集合。每种出现的模式确定一个线性区域,在区域内网络是仿射函数。
- 网络的容量是一个非正式的说法,指它能表示多复杂的函数。线性区域数是把它具体化的一种方式,参数数是另一种更粗略的方式。
- 深度、各层宽度、激活函数和连接方式的选择合称网络的架构。其中的数值是超参数,在训练前设定,区别于训练过程中调整的参数。
小结
复合两个浅层网络,就是把一个网络的输出送进另一个。当第一个网络把输入范围折叠起来时,第二个网络的函数会在每一折上各出现一次,于是段数相乘:两个各有三个单元的网络产生九段,而一个有六个单元的网络至多七段。把一个网络代入另一个可以看出,复合就是一个第二层权重矩阵秩为一的两隐藏层网络;式 7.4 的一般深层网络放开了这个矩阵,并把这种结构重复 层。反复折叠用 个参数得到 段,而浅层网络至多 段;定理也证实,对某些函数,深度可以带来指数级的效率。不过这些都是最大值:随机初始化的网络大约每个隐藏单元对应一段。深度还让训练变难,它在实践中的好处来自能良好训练、良好泛化的深层架构,后面几篇会逐步展开。第 8 篇先从训练所需的导数讲起。
注释
一般的下界。 对 个输入、 个宽度为 的隐藏层,Montúfar 等人 [3] 证明线性区域的最大个数至少为 :随深度指数增长,随宽度多项式增长。后续工作进一步收紧了上下界。、 时,这个下界是 ,比我们的 略多,因为它数的是整条实数轴,而不只是 。
宽度同样重要。 深度并非没有前提。如果 ReLU 网络的每一层都不宽于输入的个数,那么无论多深,它都不是万能逼近器:每一层的像的维数太少,无法区分某些输入。深而窄的 ReLU 网络要成为万能逼近器,宽度至少要有 [10];确切的门槛还取决于输出的个数以及如何度量逼近误差。
线性网络。 没有激活函数时,式 7.4 退化为 ,其中 (第 3 篇第 5 节)。这个乘积的秩不超过最窄那一层的宽度,所以窄的隐藏层会限制线性网络。深层线性网络不能表示任何新函数,但它的训练动力学是非线性的,是研究深度如何影响优化的标准模型。
其他激活函数。 使用 GELU 或 tanh 这样的光滑激活函数时,网络不再是分段线性的,“数区域”也就不再适用;但复合的图景仍然成立:每一层都在弯曲、折叠上一层得到的表示。
延伸阅读。 Understanding Deep Learning [1] 第 4 章讲解了网络复合、一般深层网络和深度效率的结论,并配有交互式图示。Goodfellow、Bengio 和 Courville 的著作 [2] 第 6.4 节讨论了架构设计与深度。
练习
练习 7.1 使用第 1 节的参数,计算 和 。(答案:,。)
练习 7.2 各层大小为 的全连接网络有多少个参数?(答案:。)
练习 7.3 网络 1 与自身的复合 是一个两隐藏层网络。写出它的 和 。(答案:与第 2 节相同,, 的每一行都是 ,因为网络 2 的隐藏单元参数与网络 1 相同。)
练习 7.4 一个有两个输入、四个隐藏单元的浅层网络最多能把平面分成多少个区域?如果有四个输入呢?(答案:两个输入时为 ;四个输入时为 。)
练习 7.5 有四个宽度为 3 的隐藏层的折叠网络,在 上有多少段?有多少个参数?参数数相同的浅层网络最多能产生多少段?(答案:81 段,46 个参数;46 个参数的浅层网络有 15 个单元,至多 16 段。)
练习 7.6 证明没有激活函数的两隐藏层网络 是 的仿射函数,并写出它的权重矩阵和偏置。若各层大小为 ,权重矩阵的秩最大是多少?(答案:权重为 ,偏置为 ;秩至多为 10,即最窄一层的宽度。)
练习 7.7 在各层大小为 的全连接网络中,不计偏置和激活,处理一个样本需要多少次乘加?(答案:。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Ian Goodfellow, Yoshua Bengio and Aaron Courville (2016). Deep Learning. MIT Press.
- 3: Guido Montúfar, Razvan Pascanu, Kyunghyun Cho and Yoshua Bengio (2014). On the number of linear regions of deep neural networks. Advances in Neural Information Processing Systems 27.
- 4: Matus Telgarsky (2016). Benefits of depth in neural networks. Conference on Learning Theory.
- 5: Thomas Zaslavsky (1975). Facing up to arrangements: face-count formulas for partitions of space by hyperplanes. Memoirs of the American Mathematical Society 154.
- 6: Boris Hanin and David Rolnick (2019). Complexity of linear regions in deep networks. International Conference on Machine Learning.
- 7: Ronen Eldan and Ohad Shamir (2016). The power of depth for feedforward neural networks. Conference on Learning Theory.
- 8: Kaiming He, Xiangyu Zhang, Shaoqing Ren and Jian Sun (2016). Deep residual learning for image recognition. IEEE Conference on Computer Vision and Pattern Recognition.
- 9: Lei Jimmy Ba and Rich Caruana (2014). Do deep nets really need to be deep? Advances in Neural Information Processing Systems 27.
- 10: Boris Hanin and Mark Sellke (2017). Approximating continuous functions by ReLU nets of minimal width. arXiv:1710.11278.