梯度下降需要损失对每个参数的导数(第 5 篇)。第 5 篇手工算出了只有一个隐藏单元的网络的导数,而第 7 篇引入的深层网络动辄有几十万个参数。本文完整推导一次算出全部导数的算法——反向传播 。我们先用具体数字在一条标量函数链上运行它,再给出适用于任何计算的一般规则,然后推导深层网络的矩阵形式并做一个算例。接着我们计算它的运算量和内存开销,说明反向计算如何从损失开始,把它放到自动微分的框架中,最后用反向传播的方程解释:为什么初始权重的尺度决定了深层网络能否训练。
1. 为什么需要一个算法
估计导数最简单的办法,是把参数挪动一点,看损失变化多少。中心差分
∂ ℓ ∂ ϕ ≈ ℓ ( ϕ + ϵ ) − ℓ ( ϕ − ϵ ) 2 ϵ (8.1) \frac{\partial \ell}{\partial \phi} \approx \frac{\ell(\phi + \epsilon) - \ell(\phi - \epsilon)}{2\epsilon}
\tag{8.1} ∂ ϕ ∂ ℓ ≈ 2 ϵ ℓ ( ϕ + ϵ ) − ℓ ( ϕ − ϵ ) ( 8.1 ) 对每个参数需要计算两次损失,每次都是一遍完整的前向计算。第 7 篇中 ( 784 , 256 , 256 , 10 ) (784, 256, 256, 10) ( 784 , 256 , 256 , 10 )
两个观察指向更好的方法。第一,权重乘的是激活值,所以它对损失的影响与那个激活值成正比:激活值为零时,改变权重毫无作用;激活值很大时,权重的微小变化影响很大。第二,前面某层的参数只能通过它之后的所有层影响损失。所有前面的参数共享同一条下游路径,所以这条路径上的导数可以只算一次、反复使用。反向传播同时利用了这两点:它从损失出发、反向计算损失对各中间值的导数,然后用每个参数所作用的中间值和它所乘的激活值,直接读出该参数的导数。
2. 一条函数链
我们从一个由标量运算串成的模型开始,这是包含反向传播全部步骤的最小情形。网络版本留到第 4 节。模型只有一个输入 x x x
f 0 = β 0 + ω 0 x , h 1 = sin ( f 0 ) , f 1 = β 1 + ω 1 h 1 , h 2 = exp ( f 1 ) , f 2 = β 2 + ω 2 h 2 , h 3 = cos ( f 2 ) , f 3 = β 3 + ω 3 h 3 , ℓ = ( f 3 − y ) 2 (8.2) \begin{aligned}
f_0 &= \beta_0 + \omega_0 x, & h_1 &= \sin(f_0), \\
f_1 &= \beta_1 + \omega_1 h_1, & h_2 &= \exp(f_1), \\
f_2 &= \beta_2 + \omega_2 h_2, & h_3 &= \cos(f_2), \\
f_3 &= \beta_3 + \omega_3 h_3, & \ell &= (f_3 - y)^2
\end{aligned}
\tag{8.2} f 0 f 1 f 2 f 3 = β 0 + ω 0 x , = β 1 + ω 1 h 1 , = β 2 + ω 2 h 2 , = β 3 + ω 3 h 3 , h 1 h 2 h 3 ℓ = sin ( f 0 ) , = exp ( f 1 ) , = cos ( f 2 ) , = ( f 3 − y ) 2 ( 8.2 ) 它的结构就是每层只有一个单元的深层网络。每个 f k f_k f k β k \beta_k β k ω k \omega_k ω k h k + 1 h_{k+1} h k + 1 ( x , y ) (x, y) ( x , y )
取 x = 0.6 x = 0.6 x = 0.6 y = 0.4 y = 0.4 y = 0.4 β 0 = 0.1 \beta_0 = 0.1 β 0 = 0.1 ω 0 = 1.2 \omega_0 = 1.2 ω 0 = 1.2 β 1 = − 0.3 \beta_1 = -0.3 β 1 = − 0.3 ω 1 = 0.8 \omega_1 = 0.8 ω 1 = 0.8 β 2 = 0.2 \beta_2 = 0.2 β 2 = 0.2 ω 2 = 0.5 \omega_2 = 0.5 ω 2 = 0.5 β 3 = 0.1 \beta_3 = 0.1 β 3 = 0.1 ω 3 = 1.5 \omega_3 = 1.5 ω 3 = 1.5
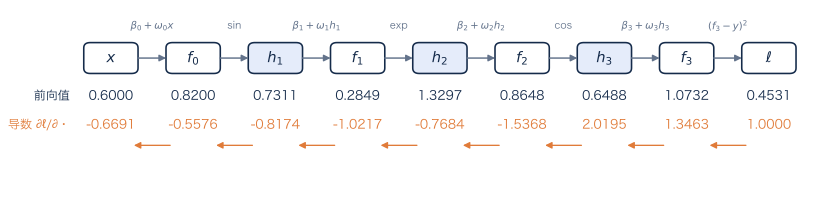
前向计算 从上到下计算式 8.2,并保存每个中间值 :f 0 = 0.1 + 1.2 × 0.6 = 0.82 f_0 = 0.1 + 1.2 \times 0.6 = 0.82 f 0 = 0.1 + 1.2 × 0.6 = 0.82 h 1 = sin 0.82 = 0.7311 h_1 = \sin 0.82 = 0.7311 h 1 = sin 0.82 = 0.7311 f 1 = − 0.3 + 0.8 × 0.7311 = 0.2849 f_1 = -0.3 + 0.8 \times 0.7311 = 0.2849 f 1 = − 0.3 + 0.8 × 0.7311 = 0.2849 h 2 = e 0.2849 = 1.3297 h_2 = e^{0.2849} = 1.3297 h 2 = e 0.2849 = 1.3297 f 2 = 0.8648 f_2 = 0.8648 f 2 = 0.8648 h 3 = cos 0.8648 = 0.6488 h_3 = \cos 0.8648 = 0.6488 h 3 = cos 0.8648 = 0.6488 f 3 = 1.0732 f_3 = 1.0732 f 3 = 1.0732 ℓ = ( 1.0732 − 0.4 ) 2 = 0.4531 \ell = (1.0732 - 0.4)^2 = 0.4531 ℓ = ( 1.0732 − 0.4 ) 2 = 0.4531
反向计算 按相反的顺序,算出损失对每个中间值的导数。我们从末端开始:
∂ ℓ ∂ f 3 = 2 ( f 3 − y ) = 1.3463 \frac{\partial \ell}{\partial f_3} = 2(f_3 - y) = 1.3463 ∂ f 3 ∂ ℓ = 2 ( f 3 − y ) = 1.3463 h 3 h_3 h 3 f 3 = β 3 + ω 3 h 3 f_3 = \beta_3 + \omega_3 h_3 f 3 = β 3 + ω 3 h 3 h 3 h_3 h 3 f 3 f_3 f 3 ω 3 \omega_3 ω 3
∂ ℓ ∂ h 3 = ∂ f 3 ∂ h 3 ∂ ℓ ∂ f 3 = ω 3 × 1.3463 = 2.0195 \frac{\partial \ell}{\partial h_3} = \frac{\partial f_3}{\partial h_3}\,\frac{\partial \ell}{\partial f_3} = \omega_3 \times 1.3463 = 2.0195 ∂ h 3 ∂ ℓ = ∂ h 3 ∂ f 3 ∂ f 3 ∂ ℓ = ω 3 × 1.3463 = 2.0195 接着,f 2 f_2 f 2 h 3 = cos f 2 h_3 = \cos f_2 h 3 = cos f 2 − sin f 2 -\sin f_2 − sin f 2
∂ ℓ ∂ f 2 = ∂ h 3 ∂ f 2 ∂ ℓ ∂ h 3 = − sin ( 0.8648 ) × 2.0195 = − 1.5368 \frac{\partial \ell}{\partial f_2} = \frac{\partial h_3}{\partial f_2}\,\frac{\partial \ell}{\partial h_3} = -\sin(0.8648) \times 2.0195 = -1.5368 ∂ f 2 ∂ ℓ = ∂ f 2 ∂ h 3 ∂ h 3 ∂ ℓ = − sin ( 0.8648 ) × 2.0195 = − 1.5368 沿着链往回,规律不断重复。每一步都把上一步算出的导数乘以一个局部 导数,即单个运算对其输入的导数:
∂ ℓ ∂ h k = ω k ∂ ℓ ∂ f k , ∂ ℓ ∂ f k − 1 = a k ′ ( f k − 1 ) ∂ ℓ ∂ h k (8.3) \frac{\partial \ell}{\partial h_k} = \omega_k \frac{\partial \ell}{\partial f_k},
\qquad
\frac{\partial \ell}{\partial f_{k-1}} = a_k'(f_{k-1})\,\frac{\partial \ell}{\partial h_k}
\tag{8.3} ∂ h k ∂ ℓ = ω k ∂ f k ∂ ℓ , ∂ f k − 1 ∂ ℓ = a k ′ ( f k − 1 ) ∂ h k ∂ ℓ ( 8.3 ) 其中 a k a_k a k k k k f k f_k f k ∂ ℓ / ∂ h 2 = − 0.7684 \partial\ell/\partial h_2 = -0.7684 ∂ ℓ / ∂ h 2 = − 0.7684 ∂ ℓ / ∂ f 1 = e 0.2849 × ( − 0.7684 ) = − 1.0217 \partial\ell/\partial f_1 = e^{0.2849} \times (-0.7684) = -1.0217 ∂ ℓ / ∂ f 1 = e 0.2849 × ( − 0.7684 ) = − 1.0217 ∂ ℓ / ∂ h 1 = − 0.8174 \partial\ell/\partial h_1 = -0.8174 ∂ ℓ / ∂ h 1 = − 0.8174 ∂ ℓ / ∂ f 0 = cos ( 0.82 ) × ( − 0.8174 ) = − 0.5576 \partial\ell/\partial f_0 = \cos(0.82) \times (-0.8174) = -0.5576 ∂ ℓ / ∂ f 0 = cos ( 0.82 ) × ( − 0.8174 ) = − 0.5576
图 8.1 函数链上的前向与反向计算。 式 8.2 的模型,x = 0.6 x = 0.6 x = 0.6 y = 0.4 y = 0.4 y = 0.4 ∂ ℓ / ∂ ℓ = 1 \partial\ell/\partial\ell = 1 ∂ ℓ / ∂ ℓ = 1
参数的导数 几乎是顺手得到的。偏置 β k \beta_k β k f k f_k f k ω k \omega_k ω k f k f_k f k h k h_k h k h 0 = x h_0 = x h 0 = x
∂ ℓ ∂ β k = ∂ ℓ ∂ f k , ∂ ℓ ∂ ω k = h k ∂ ℓ ∂ f k (8.4) \frac{\partial \ell}{\partial \beta_k} = \frac{\partial \ell}{\partial f_k},
\qquad
\frac{\partial \ell}{\partial \omega_k} = h_k \frac{\partial \ell}{\partial f_k}
\tag{8.4} ∂ β k ∂ ℓ = ∂ f k ∂ ℓ , ∂ ω k ∂ ℓ = h k ∂ f k ∂ ℓ ( 8.4 ) 这正是第 1 节的两个观察写成的式子:权重的导数,等于它作用处的导数乘以它所乘的激活值。代入我们的数值:
k k k ∂ ℓ / ∂ β k \partial\ell/\partial\beta_k ∂ ℓ / ∂ β k ∂ ℓ / ∂ ω k \partial\ell/\partial\omega_k ∂ ℓ / ∂ ω k
0
− 0.5576 -0.5576 − 0.5576 0.6 × ( − 0.5576 ) = − 0.3346 0.6 \times (-0.5576) = -0.3346 0.6 × ( − 0.5576 ) = − 0.3346
1
− 1.0217 -1.0217 − 1.0217 0.7311 × ( − 1.0217 ) = − 0.7470 0.7311 \times (-1.0217) = -0.7470 0.7311 × ( − 1.0217 ) = − 0.7470
2
− 1.5368 -1.5368 − 1.5368 1.3297 × ( − 1.5368 ) = − 2.0434 1.3297 \times (-1.5368) = -2.0434 1.3297 × ( − 1.5368 ) = − 2.0434
3
1.3463 1.3463 1.3463 0.6488 × 1.3463 = 0.8735 0.6488 \times 1.3463 = 0.8735 0.6488 × 1.3463 = 0.8735
这八个值与 ϵ = 10 − 6 \epsilon = 10^{-6} ϵ = 1 0 − 6
3. 一般规则:计算图
在函数链中,每个值到损失只有一条路径。真实网络是有分叉的:一个隐藏单元会送往下一层的每个单元,一个值也可能被使用多次。一般规则可以处理这种情况。
任何计算都可以画成一张计算图 :每个节点是一个值,从节点 u u u v v v v v v u u u u u u v 1 , … , v m v_1, \ldots, v_m v 1 , … , v m u u u
∂ ℓ ∂ u = ∑ j = 1 m ∂ v j ∂ u ∂ ℓ ∂ v j (8.5) \frac{\partial \ell}{\partial u} = \sum_{j=1}^{m} \frac{\partial v_j}{\partial u}\,\frac{\partial \ell}{\partial v_j}
\tag{8.5} ∂ u ∂ ℓ = j = 1 ∑ m ∂ u ∂ v j ∂ v j ∂ ℓ ( 8.5 ) 这个式子可以分成两部分。导数 ∂ ℓ / ∂ v j \partial\ell/\partial v_j ∂ ℓ / ∂ v j ∂ v j / ∂ u \partial v_j / \partial u ∂ v j / ∂ u v j v_j v j
一个很小的例子可以说明这个求和。设 u = 3 u = 3 u = 3 v 1 = 2 u = 6 v_1 = 2u = 6 v 1 = 2 u = 6 v 2 = u 2 = 9 v_2 = u^2 = 9 v 2 = u 2 = 9 ℓ = v 1 + v 2 = 15 \ell = v_1 + v_2 = 15 ℓ = v 1 + v 2 = 15 ∂ ℓ / ∂ v 1 = ∂ ℓ / ∂ v 2 = 1 \partial\ell/\partial v_1 = \partial\ell/\partial v_2 = 1 ∂ ℓ / ∂ v 1 = ∂ ℓ / ∂ v 2 = 1 ∂ ℓ / ∂ u = 2 × 1 + 2 u × 1 = 8 \partial\ell/\partial u = 2 \times 1 + 2u \times 1 = 8 ∂ ℓ / ∂ u = 2 × 1 + 2 u × 1 = 8 ℓ = 2 u + u 2 \ell = 2u + u^2 ℓ = 2 u + u 2 2 + 2 u = 8 2 + 2u = 8 2 + 2 u = 8
于是算法就是:做前向计算,保存每个节点的值;令 ∂ ℓ / ∂ ℓ = 1 \partial\ell/\partial\ell = 1 ∂ ℓ / ∂ ℓ = 1 无论有多少参数 ,反向计算的开销都只是前向计算的一个小常数倍。这就是反向传播的全部。本文其余部分把它具体用于深层网络,并考察它带来的结论。
4. 矩阵形式的反向传播
现在把一般规则用于第 7 篇的深层网络(式 7.4)。为方便起见,我们给预激活命名。令 h 0 = x \mathbf{h}_0 = \mathbf{x} h 0 = x k = 0 , … , K k = 0, \ldots, K k = 0 , … , K
f k = β k + Ω k h k , h k + 1 = a ( f k ) ( k < K ) (8.6) \mathbf{f}_k = \boldsymbol{\beta}_k + \boldsymbol{\Omega}_k \mathbf{h}_k,
\qquad
\mathbf{h}_{k+1} = a(\mathbf{f}_k) \ \ (k < K)
\tag{8.6} f k = β k + Ω k h k , h k + 1 = a ( f k ) ( k < K ) ( 8.6 ) 输出是 f K \mathbf{f}_K f K k k k 误差信号 定义为损失对该层预激活的导数 δ k = ∂ ℓ / ∂ f k \boldsymbol{\delta}_k = \partial\ell/\partial\mathbf{f}_k δ k = ∂ ℓ / ∂ f k D k + 1 D_{k+1} D k + 1
参数。 f k \mathbf{f}_k f k d d d f k , d = β k , d + ∑ j Ω k , d j h k , j f_{k,d} = \beta_{k,d} + \sum_j \Omega_{k,dj} h_{k,j} f k , d = β k , d + ∑ j Ω k , d j h k , j Ω k , d j \Omega_{k,dj} Ω k , d j h k , j h_{k,j} h k , j ∂ ℓ / ∂ Ω k , d j = δ k , d h k , j \partial\ell/\partial\Omega_{k,dj} = \delta_{k,d}\,h_{k,j} ∂ ℓ / ∂ Ω k , d j = δ k , d h k , j d d d j j j
∂ ℓ ∂ β k = δ k , ∂ ℓ ∂ Ω k = δ k h k ⊤ (8.7) \frac{\partial \ell}{\partial \boldsymbol{\beta}_k} = \boldsymbol{\delta}_k,
\qquad
\frac{\partial \ell}{\partial \boldsymbol{\Omega}_k} = \boldsymbol{\delta}_k \mathbf{h}_k^\top
\tag{8.7} ∂ β k ∂ ℓ = δ k , ∂ Ω k ∂ ℓ = δ k h k ⊤ ( 8.7 ) 权重梯度是一个外积 :有 D k + 1 D_{k+1} D k + 1 D k D_k D k D k + 1 × D k D_{k+1} \times D_k D k + 1 × D k Ω k \boldsymbol{\Omega}_k Ω k j j j d d d d d d j j j
反向越过权重矩阵。 h k \mathbf{h}_k h k j j j f k \mathbf{f}_k f k ∂ f k , d / ∂ h k , j = Ω k , d j \partial f_{k,d}/\partial h_{k,j} = \Omega_{k,dj} ∂ f k , d / ∂ h k , j = Ω k , d j ∂ ℓ / ∂ h k , j = ∑ d Ω k , d j δ k , d \partial\ell/\partial h_{k,j} = \sum_d \Omega_{k,dj}\,\delta_{k,d} ∂ ℓ / ∂ h k , j = ∑ d Ω k , d j δ k , d Ω k \boldsymbol{\Omega}_k Ω k j j j
∂ ℓ ∂ h k = Ω k ⊤ δ k (8.8) \frac{\partial \ell}{\partial \mathbf{h}_k} = \boldsymbol{\Omega}_k^\top \boldsymbol{\delta}_k
\tag{8.8} ∂ h k ∂ ℓ = Ω k ⊤ δ k ( 8.8 ) 形状正确:( D k × D k + 1 ) (D_k \times D_{k+1}) ( D k × D k + 1 ) D k + 1 D_{k+1} D k + 1 D k D_k D k h k \mathbf{h}_k h k Ω k \boldsymbol{\Omega}_k Ω k Ω k ⊤ \boldsymbol{\Omega}_k^\top Ω k ⊤
反向越过激活函数。 h k \mathbf{h}_k h k j j j f k − 1 \mathbf{f}_{k-1} f k − 1 j j j
δ k − 1 = a ′ ( f k − 1 ) ⊙ ∂ ℓ ∂ h k (8.9) \boldsymbol{\delta}_{k-1} = a'(\mathbf{f}_{k-1}) \odot \frac{\partial \ell}{\partial \mathbf{h}_k}
\tag{8.9} δ k − 1 = a ′ ( f k − 1 ) ⊙ ∂ h k ∂ ℓ ( 8.9 ) 其中 ⊙ \odot ⊙
式 8.7–8.9 合在一起,就是深层网络的反向计算:
做前向计算(式 8.6),保存每个 h k \mathbf{h}_k h k f k \mathbf{f}_k f k f k \mathbf{f}_k f k
由损失算出 δ K = ∂ ℓ / ∂ f K \boldsymbol{\delta}_K = \partial\ell/\partial\mathbf{f}_K δ K = ∂ ℓ / ∂ f K
对 k = K , K − 1 , … , 0 k = K, K-1, \ldots, 0 k = K , K − 1 , … , 0 k k k k > 0 k > 0 k > 0 δ k − 1 \boldsymbol{\delta}_{k-1} δ k − 1
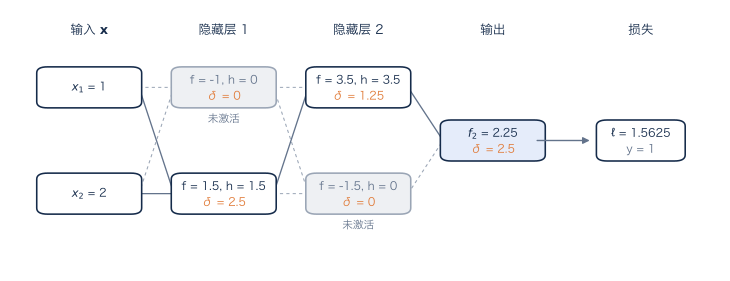
我们来算一个各层大小为 ( 2 , 2 , 2 , 1 ) (2, 2, 2, 1) ( 2 , 2 , 2 , 1 ) x = ( 1 , 2 ) ⊤ \mathbf{x} = (1, 2)^\top x = ( 1 , 2 ) ⊤ y = 1 y = 1 y = 1
Ω 0 = [ 1 − 1 0.5 1 ] , β 0 = [ 0 − 1 ] , Ω 1 = [ 1 2 − 1 − 1 ] , β 1 = [ 0.5 0 ] , Ω 2 = [ 0.5 − 1 ] , β 2 = 0.5 \boldsymbol{\Omega}_0 = \begin{bmatrix} 1 & -1 \\ 0.5 & 1 \end{bmatrix},\
\boldsymbol{\beta}_0 = \begin{bmatrix} 0 \\ -1 \end{bmatrix},\quad
\boldsymbol{\Omega}_1 = \begin{bmatrix} 1 & 2 \\ -1 & -1 \end{bmatrix},\
\boldsymbol{\beta}_1 = \begin{bmatrix} 0.5 \\ 0 \end{bmatrix},\quad
\boldsymbol{\Omega}_2 = \begin{bmatrix} 0.5 & -1 \end{bmatrix},\
\boldsymbol{\beta}_2 = 0.5 Ω 0 = [ 1 0.5 − 1 1 ] , β 0 = [ 0 − 1 ] , Ω 1 = [ 1 − 1 2 − 1 ] , β 1 = [ 0.5 0 ] , Ω 2 = [ 0.5 − 1 ] , β 2 = 0.5 前向计算得到 f 0 = ( 1 − 2 , − 1 + 0.5 + 2 ) = ( − 1 , 1.5 ) \mathbf{f}_0 = (1 - 2,\ -1 + 0.5 + 2) = (-1, 1.5) f 0 = ( 1 − 2 , − 1 + 0.5 + 2 ) = ( − 1 , 1.5 ) h 1 = ( 0 , 1.5 ) \mathbf{h}_1 = (0, 1.5) h 1 = ( 0 , 1.5 ) f 1 = ( 0.5 + 3 , − 1.5 ) = ( 3.5 , − 1.5 ) \mathbf{f}_1 = (0.5 + 3,\ -1.5) = (3.5, -1.5) f 1 = ( 0.5 + 3 , − 1.5 ) = ( 3.5 , − 1.5 ) h 2 = ( 3.5 , 0 ) \mathbf{h}_2 = (3.5, 0) h 2 = ( 3.5 , 0 ) f 2 = 0.5 + 0.5 × 3.5 = 2.25 f_2 = 0.5 + 0.5 \times 3.5 = 2.25 f 2 = 0.5 + 0.5 × 3.5 = 2.25 ( 2.25 − 1 ) 2 = 1.5625 (2.25 - 1)^2 = 1.5625 ( 2.25 − 1 ) 2 = 1.5625
反向计算从 δ 2 = 2 ( 2.25 − 1 ) = 2.5 \delta_2 = 2(2.25 - 1) = 2.5 δ 2 = 2 ( 2.25 − 1 ) = 2.5 ∂ ℓ / ∂ Ω 2 = 2.5 × ( 3.5 , 0 ) = ( 8.75 , 0 ) \partial\ell/\partial\boldsymbol{\Omega}_2 = 2.5 \times (3.5, 0) = (8.75, 0) ∂ ℓ / ∂ Ω 2 = 2.5 × ( 3.5 , 0 ) = ( 8.75 , 0 ) ∂ ℓ / ∂ h 2 = Ω 2 ⊤ × 2.5 = ( 1.25 , − 2.5 ) \partial\ell/\partial\mathbf{h}_2 = \boldsymbol{\Omega}_2^\top \times 2.5 = (1.25, -2.5) ∂ ℓ / ∂ h 2 = Ω 2 ⊤ × 2.5 = ( 1.25 , − 2.5 ) δ 1 = ( 1.25 , 0 ) \boldsymbol{\delta}_1 = (1.25, 0) δ 1 = ( 1.25 , 0 )
∂ ℓ ∂ Ω 1 = [ 1.25 0 ] [ 0 1.5 ] = [ 0 1.875 0 0 ] , ∂ ℓ ∂ h 1 = Ω 1 ⊤ [ 1.25 0 ] = [ 1.25 2.5 ] \frac{\partial \ell}{\partial \boldsymbol{\Omega}_1} = \begin{bmatrix} 1.25 \\ 0 \end{bmatrix} \begin{bmatrix} 0 & 1.5 \end{bmatrix} = \begin{bmatrix} 0 & 1.875 \\ 0 & 0 \end{bmatrix},
\qquad
\frac{\partial \ell}{\partial \mathbf{h}_1} = \boldsymbol{\Omega}_1^\top \begin{bmatrix} 1.25 \\ 0 \end{bmatrix} = \begin{bmatrix} 1.25 \\ 2.5 \end{bmatrix} ∂ Ω 1 ∂ ℓ = [ 1.25 0 ] [ 0 1.5 ] = [ 0 0 1.875 0 ] , ∂ h 1 ∂ ℓ = Ω 1 ⊤ [ 1.25 0 ] = [ 1.25 2.5 ] 把未激活的第一个单元置零,得到 δ 0 = ( 0 , 2.5 ) \boldsymbol{\delta}_0 = (0, 2.5) δ 0 = ( 0 , 2.5 ) ∂ ℓ / ∂ Ω 0 = δ 0 x ⊤ \partial\ell/\partial\boldsymbol{\Omega}_0 = \boldsymbol{\delta}_0\mathbf{x}^\top ∂ ℓ / ∂ Ω 0 = δ 0 x ⊤ ( 0 , 0 ) (0, 0) ( 0 , 0 ) ( 2.5 , 5 ) (2.5, 5) ( 2.5 , 5 )
图 8.2 在一个小 ReLU 网络中做反向传播。 各层大小为 ( 2 , 2 , 2 , 1 ) (2, 2, 2, 1) ( 2 , 2 , 2 , 1 ) x = ( 1 , 2 ) \mathbf{x} = (1, 2) x = ( 1 , 2 ) y = 1 y = 1 y = 1 f f f h h h δ = ∂ ℓ / ∂ f \delta = \partial\ell/\partial f δ = ∂ ℓ / ∂ f f < 0 f < 0 f < 0
这个例子显示了两个普遍成立的性质。第一,对这个样本,未激活的 ReLU 单元在两个方向上都阻断梯度:它的输入权重得到 δ = 0 \delta = 0 δ = 0 h = 0 h = 0 h = 0 死亡 ReLU 。第二,单个样本的权重梯度 δ k h k ⊤ \boldsymbol{\delta}_k\mathbf{h}_k^\top δ k h k ⊤
5. 批量、运算量与内存
训练使用一批 B B B L = 1 B ∑ i ℓ i L = \frac{1}{B}\sum_i \ell_i L = B 1 ∑ i ℓ i L L L H k ∈ R D k × B \mathbf{H}_k \in \mathbb{R}^{D_k \times B} H k ∈ R D k × B Δ k ∈ R D k + 1 × B \boldsymbol{\Delta}_k \in \mathbb{R}^{D_{k+1} \times B} Δ k ∈ R D k + 1 × B
∂ L ∂ Ω k = 1 B Δ k H k ⊤ , ∂ L ∂ β k = 1 B Δ k 1 (8.10) \frac{\partial L}{\partial \boldsymbol{\Omega}_k} = \frac{1}{B}\,\boldsymbol{\Delta}_k \mathbf{H}_k^\top,
\qquad
\frac{\partial L}{\partial \boldsymbol{\beta}_k} = \frac{1}{B}\,\boldsymbol{\Delta}_k \mathbf{1}
\tag{8.10} ∂ Ω k ∂ L = B 1 Δ k H k ⊤ , ∂ β k ∂ L = B 1 Δ k 1 ( 8.10 ) 形状为 ( D k + 1 × B ) ( B × D k ) = D k + 1 × D k (D_{k+1} \times B)(B \times D_k) = D_{k+1} \times D_k ( D k + 1 × B ) ( B × D k ) = D k + 1 × D k Ω k ⊤ Δ k \boldsymbol{\Omega}_k^\top\boldsymbol{\Delta}_k Ω k ⊤ Δ k
运算量。 每一层的前向计算做一次矩阵乘法 Ω k H k \boldsymbol{\Omega}_k\mathbf{H}_k Ω k H k D k + 1 D k B D_{k+1} D_k B D k + 1 D k B Δ k H k ⊤ \boldsymbol{\Delta}_k\mathbf{H}_k^\top Δ k H k ⊤ Ω k ⊤ Δ k \boldsymbol{\Omega}_k^\top\boldsymbol{\Delta}_k Ω k ⊤ Δ k ∂ ℓ / ∂ x \partial\ell/\partial\mathbf{x} ∂ ℓ / ∂ x ( 784 , 256 , 256 , 10 ) (784, 256, 256, 10) ( 784 , 256 , 256 , 10 )
内存。 式 8.10 需要 H k \mathbf{H}_k H k f k − 1 \mathbf{f}_{k-1} f k − 1 B ∑ k D k B \sum_k D_k B ∑ k D k 梯度检查点 (gradient checkpointing)[7] 用计算换内存:它只保存部分层的激活值,在反向计算时重新算出其余各层;对 K K K K \sqrt{K} K
6. 反向计算的起点:损失
反向计算从 δ K = ∂ ℓ / ∂ f K \boldsymbol{\delta}_K = \partial\ell/\partial\mathbf{f}_K δ K = ∂ ℓ / ∂ f K
平方误差。 对 ℓ = ∑ k ( f K , k − y k ) 2 \ell = \sum_k (f_{K,k} - y_k)^2 ℓ = ∑ k ( f K , k − y k ) 2 δ K = 2 ( f K − y ) \boldsymbol{\delta}_K = 2(\mathbf{f}_K - \mathbf{y}) δ K = 2 ( f K − y ) I I I I I I
softmax 与交叉熵。 做分类时,网络输出分数 z = f K \mathbf{z} = \mathbf{f}_K z = f K p k = e z k / ∑ j e z j p_k = e^{z_k}/\sum_j e^{z_j} p k = e z k / ∑ j e z j c c c ℓ = − log p c \ell = -\log p_c ℓ = − log p c log ( e z c ) = z c \log(e^{z_c}) = z_c log ( e z c ) = z c
ℓ = − z c + log ∑ j e z j \ell = -z_c + \log \sum_{j} e^{z_j} ℓ = − z c + log j ∑ e z j 其中 j j j z c z_c z c k = c k = c k = c − 1 -1 − 1 z k z_k z k e z k / ∑ j e z j = p k e^{z_k}/\sum_j e^{z_j} = p_k e z k / ∑ j e z j = p k
∂ ℓ ∂ z k = p k − 1 [ k = c ] (8.11) \frac{\partial \ell}{\partial z_k} = p_k - \mathbb{1}[k = c]
\tag{8.11} ∂ z k ∂ ℓ = p k − 1 [ k = c ] ( 8.11 ) 其中 1 [ k = c ] \mathbb{1}[k = c] 1 [ k = c ] z = ( 2.0 , 0.5 , − 1.0 ) \mathbf{z} = (2.0, 0.5, -1.0) z = ( 2.0 , 0.5 , − 1.0 ) ( 0.786 , 0.175 , 0.039 ) (0.786, 0.175, 0.039) ( 0.786 , 0.175 , 0.039 ) ( − 0.214 , 0.175 , 0.039 ) (-0.214, 0.175, 0.039) ( − 0.214 , 0.175 , 0.039 )
式 8.11 比分开计算两步更简单,数值上也更稳定。先算 p c p_c p c − log p c -\log p_c − log p c p c p_c p c − log p -\log p − log p − 1 / p -1/p − 1/ p m + log ∑ j e z j − m m + \log\sum_j e^{z_j - m} m + log ∑ j e z j − m m = max j z j m = \max_j z_j m = max j z j log ∑ j e z j \log\sum_j e^{z_j} log ∑ j e z j
7. 自动微分
第 3–6 节的内容并不限于神经网络。任何由已知局部导数的运算(加法、乘法、矩阵乘法、指数、ReLU 等)组成的程序都定义了一张计算图,第 3 节的反向计算能算出程序输出对其全部输入的导数。这就是反向模式自动微分 ,反向传播是它在神经网络上的特例。PyTorch、JAX 等库在前向计算运行时记录运算(或预先追踪程序),并为每个基本运算提供一条规则,把对输出的导数映射为对输入的导数。用户只需写前向计算。
理解为什么反向 才是正确的方向,会很有帮助。对一条层链,链式法则把梯度写成一串雅可比矩阵的乘积:∂ ℓ / ∂ x ⊤ = ∂ ℓ / ∂ f K ⊤ J K ⋯ J 1 \partial\ell/\partial\mathbf{x}^\top = \partial\ell/\partial\mathbf{f}_K^\top\,\mathbf{J}_K \cdots \mathbf{J}_1 ∂ ℓ / ∂ x ⊤ = ∂ ℓ / ∂ f K ⊤ J K ⋯ J 1 J k \mathbf{J}_k J k k k k 前向模式 自动微分就是这样一次算一列:它把对某一个输入的导数随着数值一起向前推,每个输入或参数需要一遍。对标量损失和大量参数,反向模式的开销是一次前向计算的一个小常数倍,与参数个数无关 [5] ;前向模式的开销则是参数个数的倍数。在相反的情形,即输入少、输出多时,前向模式更好。
手写或自定义的梯度应当用中心差分(式 8.1)检查。中心差分的误差与 ϵ 2 \epsilon^2 ϵ 2 ϵ \epsilon ϵ ϵ \epsilon ϵ 10 − 6 10^{-6} 1 0 − 6 10 − 6 10^{-6} 1 0 − 6 ϵ \epsilon ϵ
8. 反向计算告诉我们的深层网络训练问题
把式 8.8 和 8.9 从输出一直展开到第一层,可以看到误差信号的结构:
δ 0 = a ′ ( f 0 ) ⊙ Ω 1 ⊤ ( a ′ ( f 1 ) ⊙ Ω 2 ⊤ ( ⋯ ( a ′ ( f K − 1 ) ⊙ Ω K ⊤ δ K ) ⋯ ) ) (8.12) \boldsymbol{\delta}_0 = a'(\mathbf{f}_0) \odot \boldsymbol{\Omega}_1^\top \Big( a'(\mathbf{f}_1) \odot \boldsymbol{\Omega}_2^\top \big( \cdots \big( a'(\mathbf{f}_{K-1}) \odot \boldsymbol{\Omega}_K^\top \boldsymbol{\delta}_K \big) \cdots \big) \Big)
\tag{8.12} δ 0 = a ′ ( f 0 ) ⊙ Ω 1 ⊤ ( a ′ ( f 1 ) ⊙ Ω 2 ⊤ ( ⋯ ( a ′ ( f K − 1 ) ⊙ Ω K ⊤ δ K ) ⋯ ) ) ( 8.12 ) 到达前面某层的信号,每经过一层就乘了一个权重矩阵和一个激活斜率。许多因子的乘积往往随长度呈指数增长或衰减;前向计算也一样,每层乘一个权重矩阵、施加一次激活。权重的大小决定了是哪种情况。这正是第 5 篇未加证明给出的初始化规则背后的原因,现在可以推导它了。
前向。 设第 k k k σ 2 \sigma^2 σ 2 f k \mathbf{f}_k f k d d d D k D_k D k Ω k , d j h k , j \Omega_{k,dj}h_{k,j} Ω k , d j h k , j σ 2 E [ h k , j 2 ] \sigma^2\,\mathbb{E}[h_{k,j}^2] σ 2 E [ h k , j 2 ] E [ h k , j 2 ] = 1 2 V a r ( f k − 1 , j ) \mathbb{E}[h_{k,j}^2] = \frac{1}{2}\mathrm{Var}(f_{k-1,j}) E [ h k , j 2 ] = 2 1 Var ( f k − 1 , j )
V a r ( f k ) = D k σ 2 2 V a r ( f k − 1 ) (8.13) \mathrm{Var}(f_k) = \frac{D_k\,\sigma^2}{2}\,\mathrm{Var}(f_{k-1})
\tag{8.13} Var ( f k ) = 2 D k σ 2 Var ( f k − 1 ) ( 8.13 ) 反向。 式 8.8 的第 j j j D k + 1 D_{k+1} D k + 1 Ω k , d j δ k , d \Omega_{k,dj}\delta_{k,d} Ω k , d j δ k , d
V a r ( δ k − 1 ) = D k + 1 σ 2 2 V a r ( δ k ) (8.14) \mathrm{Var}(\delta_{k-1}) = \frac{D_{k+1}\,\sigma^2}{2}\,\mathrm{Var}(\delta_k)
\tag{8.14} Var ( δ k − 1 ) = 2 D k + 1 σ 2 Var ( δ k ) ( 8.14 ) 用文字说:每一层把前向信号的方差乘以 D k σ 2 / 2 D_k\sigma^2/2 D k σ 2 /2 D k + 1 σ 2 / 2 D_{k+1}\sigma^2/2 D k + 1 σ 2 /2 σ 2 = 2 / D k \sigma^2 = 2/D_k σ 2 = 2/ D k σ 2 = 2 / D k + 1 \sigma^2 = 2/D_{k+1} σ 2 = 2/ D k + 1 He 初始化 [6] 。所有隐藏层宽度都是 D D D σ 2 = 2 / D \sigma^2 = 2/D σ 2 = 2/ D
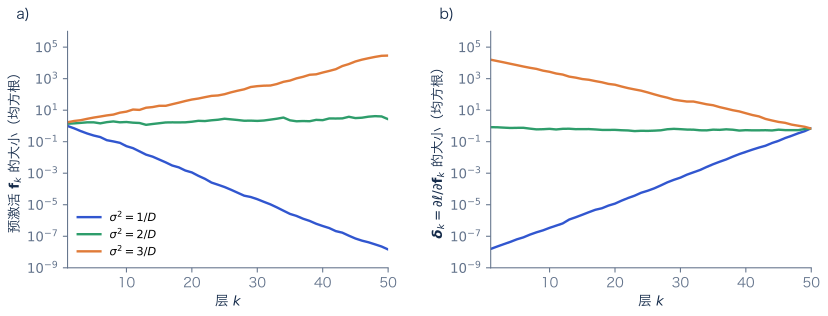
图 8.3 用模拟来验证:50 个宽度为 100 的 ReLU 层,没有偏置,一批 256 个随机输入,权重方差为 c / D c/D c / D c = 1 , 2 , 3 c = 1, 2, 3 c = 1 , 2 , 3 c = 2 c = 2 c = 2 c = 1 c = 1 c = 1 1 / 2 \sqrt{1/2} 1/2 1.45 × 10 − 8 1.45 \times 10^{-8} 1.45 × 1 0 − 8 1.58 × 10 − 8 1.58 \times 10^{-8} 1.58 × 1 0 − 8 c = 3 c = 3 c = 3 3 / 2 \sqrt{3/2} 3/2 2.9 × 10 4 2.9 \times 10^{4} 2.9 × 1 0 4 1.6 × 10 4 1.6 \times 10^{4} 1.6 × 1 0 4
图 8.3 初始权重的尺度决定信号能否穿过 50 层。 一个有 50 个宽度为 100 的层的 ReLU 网络,权重方差 σ 2 = c / D \sigma^2 = c/D σ 2 = c / D f k \mathbf{f}_k f k δ k \boldsymbol{\delta}_k δ k c = 2 c = 2 c = 2 c = 1 c = 1 c = 1 2 \sqrt{2} 2 c = 3 c = 3 c = 3 1.5 \sqrt{1.5} 1.5
看权重梯度本身时,会发现一个微妙之处。由式 8.7,第 k k k δ k h k ⊤ \boldsymbol{\delta}_k\mathbf{h}_k^\top δ k h k ⊤ c = 1 c = 1 c = 1 在每一层 都小了大致相同的总倍数 ( c / 2 ) K / 2 ≈ 3 × 10 − 8 (c/2)^{K/2} \approx 3 \times 10^{-8} ( c /2 ) K /2 ≈ 3 × 1 0 − 8 5 × 10 − 8 5 \times 10^{-8} 5 × 1 0 − 8 10 − 7 10^{-7} 1 0 − 7 10 − 8 10^{-8} 1 0 − 8 梯度消失问题 [8] 。
初始化让信号在训练开始时保持合适的大小,但不能保证权重变化后仍然如此,也解决不了另一个困难:深的普通网络比浅的训练得更差(第 7 篇第 5 节)。第 11 篇介绍的残差连接为每一层加上一条恒等路径,使式 8.12 不再只是一串乘积;归一化层则在每一层重新设定激活值的尺度。
小结
反向传播用一次反向计算算出损失对每个参数的导数,开销只是前向计算的一个小倍数。前向计算保存中间值。反向计算从损失的导数开始,按逆序访问各个值,每经过一个运算乘以一个局部导数,并对一个值的所有使用求和(式 8.5)。对深层网络,这给出三个方程:权重梯度是误差信号乘以它所乘的激活值,是一个外积;误差信号反向越过权重矩阵时乘以其转置;反向越过 ReLU 时把未激活单元置零。反向计算的开销约为前向的两倍,而且训练必须保留每层的激活值,所以训练比预测需要多得多的内存。对 softmax 加交叉熵,反向计算的起点是预测概率减去目标。把同一算法用于任何程序,就是反向模式自动微分。最后,反向计算是逐层因子的乘积,分析它的方差就得到 He 初始化;训练非常深的网络的其余困难留给第 11 篇。第 9 篇接下来从拟合训练数据转向在训练数据之外的泛化。
注释
历史。 Linnainmaa 在 1970 年描述了反向模式求导 [3] ,用来计算长串运算的舍入误差;Werbos 在 1974 年的博士论文中提出把它用于神经网络 [4] 。Rumelhart、Hinton 和 Williams [2] 在 1986 年表明,它能让多层网络学到有用的内部表示,这篇论文使它得到广泛使用。Baydin 等人 [9] 综述了机器学习中的自动微分。
二阶导数。 反向传播给出梯度。二阶导数即海森矩阵有 P 2 P^2 P 2
其他初始化。 对在零附近近似线性的激活函数(如 tanh),去掉式 8.13 中的因子 1 / 2 1/2 1/2 σ 2 = 1 / D \sigma^2 = 1/D σ 2 = 1/ D [10] 在前向与反向两个条件之间折中,取 σ 2 = 2 / ( D k + D k + 1 ) \sigma^2 = 2/(D_k + D_{k+1}) σ 2 = 2/ ( D k + D k + 1 )
不可导点。 ReLU 在 0 处没有导数,取最大值和取绝对值等运算也有类似的拐点。自动微分在那里选取一个导数值(对 ReLU 取 0)。由于预激活恰好为零的概率可以忽略,这个选择在实践中很少有影响。
延伸阅读。 Understanding Deep Learning [1] 第 7 章对同一个玩具模型和深层网络推导了反向传播,并讲解了初始化。Griewank 和 Walther [5] 是自动微分的标准参考书。
练习
练习 8.1 对第 2 节的函数链,计算 ∂ ℓ / ∂ x \partial\ell/\partial x ∂ ℓ / ∂ x (答案:ω 0 ∂ ℓ / ∂ f 0 = 1.2 × ( − 0.5576 ) = − 0.6691 \omega_0\,\partial\ell/\partial f_0 = 1.2 \times (-0.5576) = -0.6691 ω 0 ∂ ℓ / ∂ f 0 = 1.2 × ( − 0.5576 ) = − 0.6691
练习 8.2 在第 4 节的网络中,把目标改为 y = 3 y = 3 y = 3 (答案:前向计算不变,δ 2 = 2 ( 2.25 − 3 ) = − 1.5 \delta_2 = 2(2.25 - 3) = -1.5 δ 2 = 2 ( 2.25 − 3 ) = − 1.5 δ 2 \delta_2 δ 2 − 1.5 / 2.5 = − 0.6 -1.5/2.5 = -0.6 − 1.5/2.5 = − 0.6 ∂ ℓ / ∂ Ω 2 = ( − 5.25 , 0 ) \partial\ell/\partial\boldsymbol{\Omega}_2 = (-5.25, 0) ∂ ℓ / ∂ Ω 2 = ( − 5.25 , 0 ) ∂ ℓ / ∂ Ω 0 \partial\ell/\partial\boldsymbol{\Omega}_0 ∂ ℓ / ∂ Ω 0 ( 0 , 0 ) (0, 0) ( 0 , 0 ) ( − 1.5 , − 3 ) (-1.5, -3) ( − 1.5 , − 3 )
练习 8.3 对分数 z = ( 2.0 , 0.5 , − 1.0 ) \mathbf{z} = (2.0, 0.5, -1.0) z = ( 2.0 , 0.5 , − 1.0 ) (答案:( 0.786 , − 0.825 , 0.039 ) (0.786, -0.825, 0.039) ( 0.786 , − 0.825 , 0.039 ) ∑ k p k − 1 = 0 \sum_k p_k - 1 = 0 ∑ k p k − 1 = 0
练习 8.4 设 u = 1 u = 1 u = 1 v 1 = 2 u v_1 = 2u v 1 = 2 u v 2 = u 2 v_2 = u^2 v 2 = u 2 ℓ = v 1 v 2 \ell = v_1 v_2 ℓ = v 1 v 2 ∂ ℓ / ∂ u \partial\ell/\partial u ∂ ℓ / ∂ u ℓ \ell ℓ u u u (答案:∂ ℓ / ∂ v 1 = v 2 = 1 \partial\ell/\partial v_1 = v_2 = 1 ∂ ℓ / ∂ v 1 = v 2 = 1 ∂ ℓ / ∂ v 2 = v 1 = 2 \partial\ell/\partial v_2 = v_1 = 2 ∂ ℓ / ∂ v 2 = v 1 = 2 ∂ ℓ / ∂ u = 2 × 1 + 2 u × 2 = 6 \partial\ell/\partial u = 2 \times 1 + 2u \times 2 = 6 ∂ ℓ / ∂ u = 2 × 1 + 2 u × 2 = 6 ℓ = 2 u 3 \ell = 2u^3 ℓ = 2 u 3 6 u 2 = 6 6u^2 = 6 6 u 2 = 6
练习 8.5 对一批 256 个样本,( 784 , 256 , 256 , 10 ) (784, 256, 256, 10) ( 784 , 256 , 256 , 10 ) (答案:256 × ( 268,800 + 336,896 ) = 155,058,176 256 \times (268{,}800 + 336{,}896) = 155{,}058{,}176 256 × ( 268 , 800 + 336 , 896 ) = 155 , 058 , 176
练习 8.6 对恒等激活函数 a ( z ) = z a(z) = z a ( z ) = z (答案:没有 ReLU 时 E [ h 2 ] = V a r ( f ) \mathbb{E}[h^2] = \mathrm{Var}(f) E [ h 2 ] = Var ( f ) V a r ( f k ) = D k σ 2 V a r ( f k − 1 ) \mathrm{Var}(f_k) = D_k\sigma^2\,\mathrm{Var}(f_{k-1}) Var ( f k ) = D k σ 2 Var ( f k − 1 ) σ 2 = 1 / D k \sigma^2 = 1/D_k σ 2 = 1/ D k
练习 8.7 在图 8.3 中 c = 1 c = 1 c = 1 0.988 0.988 0.988 1.45 × 10 − 8 1.45 \times 10^{-8} 1.45 × 1 0 − 8 (答案:( 1 / 2 ) 49 / 2 ≈ 4.2 × 10 − 8 (1/2)^{49/2} \approx 4.2 \times 10^{-8} ( 1/2 ) 49/2 ≈ 4.2 × 1 0 − 8 1.47 × 10 − 8 1.47 \times 10^{-8} 1.47 × 1 0 − 8
参考文献
1: Simon J.D. Prince (2023). Understanding Deep Learning 2: David Rumelhart, Geoffrey Hinton and Ronald Williams (1986). Learning representations by back-propagating errors . Nature 323, 533–536.3: Seppo Linnainmaa (1970). The representation of the cumulative rounding error of an algorithm as a Taylor expansion of the local rounding errors. Master's thesis, University of Helsinki.4: Paul Werbos (1974). Beyond regression: new tools for prediction and analysis in the behavioral sciences. PhD thesis, Harvard University.5: Andreas Griewank and Andrea Walther (2008). Evaluating Derivatives: Principles and Techniques of Algorithmic Differentiation , 2nd edition. SIAM.6: Kaiming He, Xiangyu Zhang, Shaoqing Ren and Jian Sun (2015). Delving deep into rectifiers: surpassing human-level performance on ImageNet classification . International Conference on Computer Vision .7: Tianqi Chen, Bing Xu, Chiyuan Zhang and Carlos Guestrin (2016). Training deep nets with sublinear memory cost . arXiv:1604.06174.8: Yoshua Bengio, Patrice Simard and Paolo Frasconi (1994). Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks 5(2), 157–166.9: Atılım Güneş Baydin, Barak Pearlmutter, Alexey Radul and Jeffrey Siskind (2018). Automatic differentiation in machine learning: a survey . Journal of Machine Learning Research 18(153), 1–43.10: Xavier Glorot and Yoshua Bengio (2010). Understanding the difficulty of training deep feedforward neural networks . International Conference on Artificial Intelligence and Statistics .