正则化:少拟合一点,泛化更好
在同一个例子上讲解权重衰减、提前停止、集成、dropout、数据增强与双下降。
第 6 篇说明,灵活的模型可能拟合训练数据中的噪声,然后预测得很差;当时的办法是用验证集选择模型复杂度:选 3 次多项式而不是 9 次。对深层网络,这个工具太粗了。把网络缩小到拟合不了噪声,它往往也拟合不了真正有用的规律;而在实践中,最好的结果往往来自大到足以记住整个训练集的网络。正则化就是让这样的网络依然能够泛化的一系列技术。本文在同一个例子上逐一讲解主要的几种:惩罚权重的大小、提前停止训练、对多个模型取平均、dropout、加入噪声与数据增强,以及标签平滑。每一种都配有一个推导,说明它在一个可以精确求解的简单情形中做了什么。最后一部分介绍过参数化的情形,在那里第 6 篇的经典图景需要修正。
1. 一个过拟合的网络
全文使用同一个例子。数据是 20 个训练点 , 在 0 到 1 之间均匀抽取,,噪声 服从标准差为 0.25 的正态分布。另有一个来自同一来源的 500 点验证集。由于噪声方差为 ,即使是真实曲线 ,其验证误差也约为 0.0625。平均而言没有哪个模型能做得更好,所以 0.0625 是下文所有数字的下限。
模型是各层大小为 的全连接 ReLU 网络,有 4,353 个参数(式 7.5),每个训练点摊到 200 多个。我们训练它最小化均方误差
其中 ,使用全批量 Adam [5](第 5 篇),学习率 0.003,训练 30,000 步,从 He 初始化开始。第 2–5 节的每个实验都使用这套设置,每次只改变一处。
不加任何正则化时,训练误差降到 0.0091,验证误差为 0.157(图 9.1a,橙色)。训练误差远低于噪声水平 0.0625,这正是过拟合的标志:网络拟合了这 20 个点上具体的噪声值,在点与点之间弯出了真实曲线所没有的形状。
我们把任何旨在降低新数据上的误差、而不是训练数据上误差的训练改动,都称为正则化。有些正则化方法改变损失(第 2 节和第 6 节),另一些改变训练过程(第 3–5 节),它们对解的影响是隐式的。
2. L2 正则化与权重衰减
最常用的显式正则化,是在损失上加上权重的平方和:
这个式子可以分成两部分。第一项是式 9.1 的数据损失。第二项是一个随权重增大而增大的惩罚,对每个权重矩阵的每个元素求和。偏置通常不计入:它们只平移输出和激活阈值,不会让函数变陡,惩罚它们只会无端地把输出拉向零。正则化强度 是一个超参数,权衡这两项。用文字说:在拟合数据差不多好的参数设置中,偏向权重较小的那个。
惩罚项对权重 的梯度是 ,所以学习率为 的一步梯度下降变成:
每一步先把每个权重乘以 缩小一点,再做通常的梯度步。这就是 L2 正则化又叫权重衰减 [4] 的原因。取 、,这个因子是 0.998:一个完全得不到梯度的权重,1,000 步后会衰减到原值的 13.5%。只有数据持续推动的权重才能保持较大。
图 9.1b 是用九个 值训练网络的结果。 很小时几乎没有变化。随着 增大,训练误差上升,因为网络不能再随意弯曲去贴近每个带噪声的点;验证误差则下降。扫描中最好的 ,训练误差为 0.0351,验证误差为 0.0818,接近下限 0.0625。拟合出的曲线(图 9.1a,蓝色)沿着正弦曲线走,不理会单个的噪声值。权重也小得多:最大的权重绝对值从 8.03 降到 1.54,权重平方和从 566.7 降到 20.8。 超过 0.01 后惩罚占了主导: 时网络被压得接近零权重,训练和验证误差都约为 0.65,这是欠拟合。
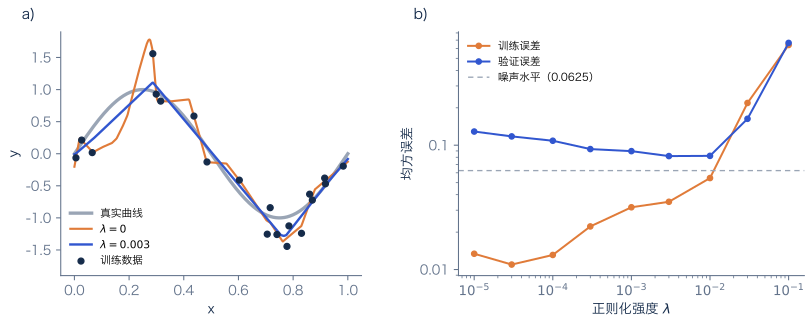
图 9.1 对一个拟合 20 个点、有 4,353 个参数的网络做 L2 正则化。 a)真实曲线(灰色)、训练数据(深色点)和两个训练好的网络:不加正则化(橙色),弯曲以贴近每个点;(蓝色),沿着趋势走。b) 从 到 时训练 30,000 步后的训练误差和验证误差。虚线是噪声方差 0.0625,任何模型可期望的最低验证误差。不加正则化时两个误差分别为 0.0091 和 0.157。
TensorFlow Playground 可以在分类问题上展示同样的效果。下面的网络有三个隐藏层,每层 8 个 ReLU 单元,共 177 个参数,只用带噪声的圆形数据集的十分之一来训练,其余十分之九作为测试集。
点击播放,观察输出图上方的两条损失曲线。训练损失一直下降,但大约一百轮之后,测试损失开始上升。到第 800 轮,训练损失在 0.2 左右或更低,测试损失高于 0.4。决策边界伸出细长的触手,去够单个的训练点。 然后把 Regularization rate 改成 0.03,网络会重新开始。这一次训练损失停在更高的位置,约 0.27,测试损失稳定在 0.36 左右,不再上升。 再试试 0.3。惩罚项占了主导,两个损失都停在 0.5 左右:网络欠拟合,就像图 9.1b 中最大的几个 λ。
为什么小权重意味着更平滑的函数
对 ReLU 网络,小权重与函数性质良好之间的联系可以精确说明。在一个线性区域内,每个 ReLU 要么相当于乘 1,要么相当于乘 0,所以对一个输入、一个输出的网络,斜率为
其中 是对角矩阵,第 层每个激活单元对应 1,未激活单元对应 0。乘以 只会让向量变短,所以斜率的绝对值不超过各权重矩阵大小的乘积 (这里用每个矩阵能把向量拉长的最大倍数衡量其大小)。要穿过彼此靠近的带噪声的点,函数需要很陡的段,而陡的段需要大的权重。式 9.2 的惩罚让这样的权重代价高昂。这是一个上界而不是等式:权重大的网络不一定陡,但陡的网络一定有大的权重。
概率的解读
把参数看作不确定的量,也能得到 L2 正则化。假设噪声服从方差为 的正态分布,并且在看到数据之前,我们认为每个权重都来自均值为 0、方差为 的正态分布,这称为先验。给定数据后最可能的权重,使似然乘以先验最大。取负对数并去掉与参数无关的项,得到
再乘以 (不改变最小值的位置),就变成式 9.2,其中 。由此可以得到两点。数据越多,惩罚越弱,因为数据越来越压过先验。而且 有了含义:它是噪声方差相对于我们预期的权重大小的比值。对我们的数据,、,先验标准差取 1,得到 ,接近验证集选出的值。不过这里的先验宽度是猜的,不应过度解读这种吻合。这种估计称为最大后验(maximum a posteriori,MAP)估计。
变体
把式 9.2 中的平方换成绝对值,就得到 L1 正则化。它的梯度对每个非零权重大小相同,因此会把许多权重压到恰好为零,适用于需要稀疏模型的场合。
使用 Adam 这样的自适应优化器时,式 9.2 和式 9.3 不再是一回事。Adam 把每个参数的梯度除以其大小的滑动估计,于是惩罚梯度 对每个权重的缩放都不同,大而频繁更新的权重衰减得比预期少。解耦权重衰减(AdamW)[6] 在自适应缩放之外,直接对权重施加式 9.3 中的缩小。训练 Transformer 时通常用它。我们的实验在 Adam 中使用了惩罚项,这是较简单的形式。
3. 提前停止
梯度下降不是一步跳到训练损失的最小值,而是逐步走过去,走过的路径很重要。图 9.2a 记录了未正则化网络在 30,000 步中的训练误差和验证误差。训练误差一直在降。验证误差降到第 312 步,此时训练误差为 0.0327、验证误差为 0.0925,之后随着网络开始拟合噪声,慢慢升到 0.157。在第 312 步停止,得到的验证误差几乎与最好的权重衰减一样,而且不用选择 。
提前停止正是这样做的:训练中定期计算验证误差,保存迄今验证误差最低时的参数副本,当它在一段时间内(若干次评估,称为耐心值)不再改善时就停止。训练步数变成了由验证集选择的超参数,而且调它不需要额外代价,因为一次训练就经历了所有候选值。
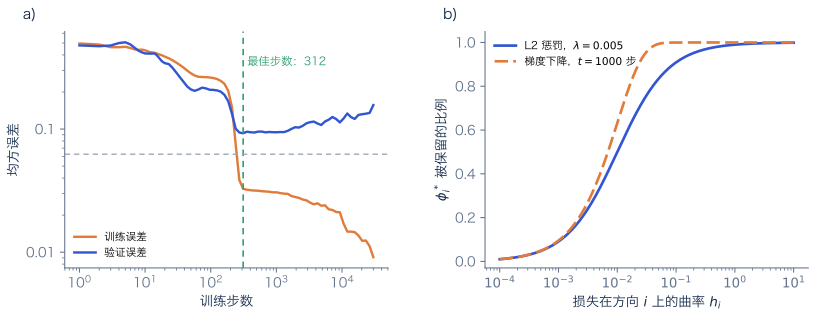
图 9.2 提前停止。 a)未正则化网络训练过程中的训练误差和验证误差。验证误差在第 312 步最低(绿色),之后网络继续靠拟合噪声降低训练误差。灰色虚线为噪声水平。b)对二次损失,最小值 的每个分量被保留的比例: 的 L2 惩罚(式 9.6),以及 、从零开始的 1,000 步梯度下降(式 9.5)。两者都保留高曲率方向上的分量、压制低曲率方向上的分量,截止位置几乎相同。
提前停止相当于 L2 惩罚
对二次损失,可以精确推导它与 L2 正则化的联系。在最小值 附近把损失写成
其中 是二阶导数矩阵,对称,特征值 ,特征向量 。特征值 是损失在方向 上的曲率:数据对参数约束紧的方向上它大,移动参数几乎不改变拟合的方向上它小。
梯度下降。 梯度为 ,所以误差 满足 。从 (即 )出发, 步后 沿 的分量为:
L2 惩罚。 在式 9.4 上加 ,令梯度为零,得 ,所以沿 :
两个式子都把未正则化解的每个分量乘以一个 0 到 1 之间的因子:曲率高处接近 1,曲率低处接近 0。当 很小时,;当 时,两个因子在差不多相同的曲率处从 0 变到 1。图 9.2b 展示了 、、 的情形。例如在曲率 的方向上,惩罚保留 的 ,梯度下降保留 。
用文字说:训练步数少,大致相当于一个强度与步数成反比的 L2 惩罚。这个推导假设损失是二次的、使用普通梯度下降并从零开始。网络的损失不是二次的,训练也从随机权重开始,所以在网络上这个结论只是定性的;但其机制——约束紧的方向先被拟合,约束松的方向最后才被拟合——仍然成立,并解释了图 9.2a 的形状。
4. 集成
降低新数据上误差的另一种办法,是训练几个模型并对它们的预测取平均。好处来自把各模型误差中互不相同的部分平均掉。
设 个模型在某个输入上的误差为 ,均值为零,方差为 ,任意两个模型之间的相关系数为 。平均的误差为 ,其方差为
第一步把和的方差展开为方差与协方差:共有 个方差,以及 个有序的不同模型对,每对的协方差为 。用文字说:取平均以 的速度消除误差中不相关的部分,相关的部分则原封不动。、 时,方差降到 ; 时,无论多少个模型都不能把它降到 以下。
在我们的例子中,我们训练了五个只有随机初始权重不同的未正则化网络。它们的验证误差分别为 0.157、0.204、0.146、0.174 和 0.134,平均 0.163;它们预测的平均值验证误差为 0.139。以真实曲线为基准(去掉噪声下限)衡量,均方偏差从单个网络的 0.089 降到集成的 0.065。五个网络偏差之间的平均相关系数为 0.73,因为它们都在同样的 20 个点上训练、拟合了同样的噪声;式 9.7 预测的因子是 ,即 0.070,与实测的 0.065 接近(式子假设方差相等、误差均值为零,这只是近似成立)。
集成的诀窍在于降低 。网络可以在初始化(如本例)、训练样本的顺序、架构或训练数据上不同。Bagging [7] 让每个模型在一个自助样本上训练,即从训练集中有放回地抽取 个样本。由独立初始化的网络组成的集成,是提高准确率和估计预测不确定性最可靠的方法之一 [8]。它的代价是预测时需要 倍的计算量,这常常是不用它的原因。
5. Dropout
Dropout [3] 以一个网络的代价,近似一个巨大的集成。在每个训练步,每个隐藏单元以概率 被独立地置零,保留下来的单元放大 倍:
这里 是由 0 和 1 组成的随机掩码,每个样本、每一步都重新抽取; 表示“以概率 取 1,否则取 0”。放大保证了期望值不变,,所以预测时可以不加掩码使用整个网络,下一层收到的输入平均大小相同。例如 时,激活值 与掩码 给出 。在反向计算中,同样的掩码和放大倍数也乘到误差信号上,相当于式 8.9 中多了一个因子。
在两个隐藏层上都使用 dropout 训练我们的网络, 时验证误差为 0.113, 时为 0.093, 时为 0.103;不用 dropout 时为 0.157。 时训练误差为 0.067,不再低于噪声水平。
作为集成的 dropout。 每个掩码选出一个子网络。我们的网络有 128 个隐藏单元,所以共有 个可能的子网络,它们共享同一组权重,每个训练步训练其中随机的一个。预测时用期望激活值运行完整网络,近似于对所有子网络的预测取平均。如果被丢弃的层之后不再有非线性,这个近似是精确的,否则只是近似。原作者还认为 dropout 能防止某个单元依赖其他特定单元的存在(“共适应”);这个解释说得通,但它是假设,不是推导。
作为惩罚的 dropout。 对线性模型,可以精确算出它的作用。设对输入施加 dropout 后预测为 。它对掩码的均值是 ;由于各掩码相互独立,且 ,它的方差是 。期望平方误差等于均值的平方误差加上方差:
用文字说:平均而言,dropout 是在训练不带 dropout 的模型,外加一个 L2 惩罚,其中每个权重受到的惩罚与它所乘输入的平方大小成正比 [9]。 时因子 为 1。所以 dropout 是一种依赖数据的权重衰减,重要的区别在于它的惩罚会根据每个输入的实际大小自动调整。
全连接层常用的 dropout 比例是 0.1 到 0.5。卷积层用得较少,因为卷积单元与相邻单元高度相关;Transformer 通常使用 0.1 这样的小比例。Dropout 与批归一化(第 11 篇)相互影响,因为它改变了训练与预测时激活值的统计量。
6. 噪声、数据增强与标签平滑
在输入上加噪声。 训练时给输入加随机噪声,是另一种隐式惩罚。对输入为 的线性模型,其中噪声均值为零、协方差为 ,与式 9.9 同样的“均值加方差”论证给出
这恰好是 与 成正比的 L2 正则化 [10]。对网络,这种等价在噪声的一阶近似下成立,惩罚的是输出对输入的导数的大小:网络被鼓励不要随输入变化而急剧变化。
数据增强。 我们常常知道哪些变换不会改变正确的输出:一张猫的照片水平翻转、稍微裁剪或调暗一点,仍然是猫。数据增强在每个训练步对训练样本施加这类随机变换,让网络看到每个样本的许多版本。它把仅靠数据无法提供的任务知识编码进来,即输出应当对哪些变化不敏感。对图像,随机裁剪和翻转从最早的大型卷积网络起就是标准做法 [11],数据增强通常是视觉模型最有效的单一正则化手段。变换必须真正保持标签不变:手写的 6 旋转 180 度就成了 9,翻转含文字的图像会改变文字。更进一步的 mixup [12] 用成对样本的加权平均来训练,标签也取同样的加权平均。
标签平滑。 对使用交叉熵损失的分类,目标是独热向量:正确类别的概率为 1。只有当正确类别的分数以越来越大的差距超过其他类别时,损失才趋近零,所以训练会不停地把分数拉开,网络变得过度自信。标签平滑 [13] 把目标换成 ,把一小部分概率 均匀分给全部 个类别。用这个目标重复式 8.11 的推导,得到误差信号 。对第 4 篇的分数 ,概率为 ;取 、,目标为 ,误差信号为 ,其第一个元素小于独热目标下的 。现在损失在有限的分数差处、即 时取最小值。
7. 过参数化与双下降
我们的网络每个训练点摊到 200 多个参数,即使不加正则化,验证误差也只有 0.157:比加了正则化差,但远不像第 6 篇 9 次多项式那样灾难性。这在现代深度学习中很典型,“参数多于数据点就会无可救药地过拟合”的经典图景并不适用。Zhang 等人 [14] 在 2017 年把这一点说得很尖锐:标准的图像分类网络即使在 CIFAR-10 的每个标签都换成随机标签时,也能完美拟合,因此它们有能力记住任何东西;然而在真实标签上,同样的网络泛化得很好。数参数并不能解释泛化。
一个简单的模型可以说明实际发生了什么。取一个有 个隐藏单元的浅层网络,第一层固定为随机值,激活函数为余弦:单元 计算 ,频率 随机(正态分布,标准差 40),相位 也随机。只训练输出层,即包括偏置在内的 个权重,在 20 个点上做最小二乘。模型关于可训练权重是线性的,所以拟合可以精确算出。当 时,有无穷多个权重向量能恰好拟合这 20 个点。我们取其中权重平方和最小的那个,即最小范数解。这不是随意的选择:在最小二乘损失上从零开始做梯度下降,恰好收敛到这个解。因为每个梯度都是训练输入特征向量的组合,权重永远不会离开这些向量张成的空间,而这个空间中唯一的精确拟合就是最小范数解。
图 9.3 显示了验证误差随 增长的变化,取第一层 60 次随机抽取的中位数。起初曲线是经典的 U 形:误差从 2 个单元时的 0.70 降到 8 个单元时的 0.45,然后随着模型开始拟合噪声而上升。在 处达到约 5,500 的峰值。然后它又下降: 时为 2.7, 时为 0.30, 时为 0.297,低于 U 形的最低点。峰值之后的第二次下降称为双下降 [15]。
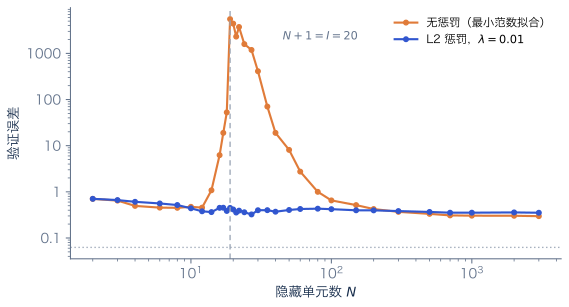
图 9.3 双下降。 一个有 个余弦隐藏单元的浅层网络的验证误差,第一层随机且固定,只把输出权重拟合到 20 个训练点上;取第一层 60 次抽取的中位数。橙色:无惩罚,最小范数最小二乘。在可训练权重数等于训练点数处(,虚线)误差达到峰值,之后又下降。蓝色: 的 L2 惩罚消除了峰值。点线为噪声水平。
峰值的原因很简单。在 时,恰好只有一组权重能拟合全部 20 个点;只用 20 个固定的波形去穿过带噪声的值,通常需要巨大的权重,让函数在点与点之间剧烈摆动。单元更少时没有精确拟合,最小二乘会把噪声平均掉;单元更多时有许多精确拟合,最小范数解是其中最平缓的。随着 增长,精确拟合的集合变大,其中最平缓的那个也越来越平滑。起正则化作用的是训练算法自带的偏好,这里是偏好小权重。加上显式惩罚(,蓝色)后峰值消失,说明它是阈值处无正则化拟合的症状,而不是模型规模本身的性质。
Nakkiran 等人 [16] 在按常规方式训练的深层网络中观察到同样的形状,既随宽度出现,也随训练轮数出现;他们还表明,合适的正则化可以消除峰值。有几点保留意见能让这幅图景保持客观。双下降在正则化很少或没有、且标签有噪声时最明显。第二次下降不一定低于第一个最低点;本例中低于(0.30 对 0.45),但两者都远不如第 2 节加了权重衰减的网络(0.082),因为高频的随机余弦特征并不是表示正弦波的好基函数。而且,与这个线性模型不同,深层网络中梯度下降的隐式偏好尚未完全刻画清楚;严重过参数化的网络为什么能泛化得这么好,仍是活跃的研究问题。
8. 实践中的正则化
这些技术可以组合使用,实践者很少只靠一种。面对新问题,一种常见做法是先用一个大到足以很好地拟合训练集的网络,以确认模型和训练流程是可行的,然后逐步加入正则化,直到验证误差不再改善。
| 技术 | 改变了什么 | 常见设置 | 额外代价 |
|---|---|---|---|
| 权重衰减 | 在损失上加 ,或每步缩小权重 | 取 到 ,视优化器而定;配合 Adam 时使用解耦形式 | 无 |
| 提前停止 | 训练时长 | 选验证误差最低的那一步 | 定期验证 |
| 数据增强 | 训练样本 | 针对任务的、保持标签不变的变换 | 数据处理 |
| Dropout | 训练时的隐藏激活 | 取 0.1 到 0.5 | 收敛变慢 |
| 标签平滑 | 分类目标 | 无 | |
| 集成 | 预测 | 3 到 10 个模型 | 倍计算量 |
这些范围在已发表的工作中很常见,但不是规则;合适的值取决于数据、架构和优化器,并且要用验证集来选,绝不能用测试集(第 6 篇)。后面介绍的两种架构组件也起正则化作用。批归一化(第 11 篇)通过批统计量引入噪声。卷积层(第 10 篇)是图像上最强的正则化手段:通过在不同位置共享权重,它在训练开始之前就排除了全连接网络能表示的大多数函数。
小结
参数远多于训练样本的网络会拟合数据中的噪声。正则化改变训练方式,让它少拟合一些噪声。权重衰减对权重平方加惩罚,这限制了 ReLU 网络变化的陡峭程度,并对应于权重的正态先验。提前停止在验证误差最低时停止训练;对二次损失,它近似等价于一个强度随步数增加而减弱的 L2 惩罚,因为梯度下降先拟合约束紧的方向。集成把几个模型误差中不相关的部分平均掉,dropout 则近似一个指数级大的子网络集成;对线性模型,它等价于一个依赖数据的 L2 惩罚。输入噪声、数据增强和标签平滑把知识或谨慎放进数据和目标中。最后,高度过参数化的模型之所以能泛化,是因为在众多能拟合数据的解中,训练偏好简单的那个,这也产生了测试误差随模型规模的双下降。第 10 篇转向图像上最强的内置正则化手段:卷积层。
注释
泛化理论。 训练误差与测试误差之差的经典上界依赖参数个数等容量度量,对大型网络来说松得完全无法解释其泛化。基于权重大小的上界(范数上界)、基于参数能被扰动多少而不改变损失的上界(平坦性、PAC-Bayes 上界),以及基于训练后网络可压缩性的上界,给出了更紧但仍不完整的解释。Understanding Deep Learning [1] 第 9 章梳理了相关证据。
随机梯度下降的隐式正则化。 用小批量训练会给每一步加入噪声,有证据表明这种噪声偏好损失中宽而平坦的区域,而这些区域往往泛化得更好。平坦性与泛化之间的联系仍有争议,因为平坦性取决于参数的缩放方式。
迁移学习。 训练集很小时,最有效的正则化往往是从一个在相关的大数据集上训练好的网络出发,再加以调整(微调)。预训练的权重起到强先验的作用。在大规模无标注数据上预训练,是第 12 篇介绍的语言模型的基础。
延伸阅读。 Understanding Deep Learning [1] 第 9 章,以及 Goodfellow、Bengio 和 Courville [2] 第 7 章,讲解了正则化,包括第 3 节对提前停止的分析。
练习
练习 9.1 按第 2 节的 MAP 解读,噪声标准差 0.5、先验标准差 0.1、100 个训练样本对应的 是多少?(答案:。)
练习 9.2 权重衰减因子 ,且数据不提供梯度时,一个权重经过多少步减半?(答案:。)
练习 9.3 十个模型的误差方差为 ,两两相关系数为 0.8。它们平均的误差方差是多少?模型数趋于无穷时的极限是多少?(答案:;极限为 。)
练习 9.4 对 用掩码 施加 的反向缩放 dropout。(答案:。)
练习 9.5 推导式 9.10。(提示:;展开平方,并利用 和 。)
练习 9.6 标签平滑 、 个类别时,目标概率是多少?模型在一个样本上能达到的最小交叉熵损失是多少?(答案:正确类别 0.91,其他每个类别 0.01。损失 在 时最小,等于 。)
练习 9.7 用式 9.5 和 9.6,取 ,比较在曲率 的方向上,1,000 步梯度下降与 的 L2 惩罚各保留 的多少。(答案: 和 。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Ian Goodfellow, Yoshua Bengio and Aaron Courville (2016). Deep Learning. MIT Press.
- 3: Nitish Srivastava, Geoffrey Hinton, Alex Krizhevsky, Ilya Sutskever and Ruslan Salakhutdinov (2014). Dropout: a simple way to prevent neural networks from overfitting. Journal of Machine Learning Research 15(56), 1929–1958.
- 4: Anders Krogh and John Hertz (1991). A simple weight decay can improve generalization. Advances in Neural Information Processing Systems 4.
- 5: Diederik Kingma and Jimmy Ba (2015). Adam: a method for stochastic optimization. International Conference on Learning Representations.
- 6: Ilya Loshchilov and Frank Hutter (2019). Decoupled weight decay regularization. International Conference on Learning Representations.
- 7: Leo Breiman (1996). Bagging predictors. Machine Learning 24(2), 123–140.
- 8: Balaji Lakshminarayanan, Alexander Pritzel and Charles Blundell (2017). Simple and scalable predictive uncertainty estimation using deep ensembles. Advances in Neural Information Processing Systems 30.
- 9: Stefan Wager, Sida Wang and Percy Liang (2013). Dropout training as adaptive regularization. Advances in Neural Information Processing Systems 26.
- 10: Chris Bishop (1995). Training with noise is equivalent to Tikhonov regularization. Neural Computation 7(1), 108–116.
- 11: Alex Krizhevsky, Ilya Sutskever and Geoffrey Hinton (2012). ImageNet classification with deep convolutional neural networks. Advances in Neural Information Processing Systems 25.
- 12: Hongyi Zhang, Moustapha Cisse, Yann Dauphin and David Lopez-Paz (2018). mixup: beyond empirical risk minimization. International Conference on Learning Representations.
- 13: Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens and Zbigniew Wojna (2016). Rethinking the Inception architecture for computer vision. IEEE Conference on Computer Vision and Pattern Recognition.
- 14: Chiyuan Zhang, Samy Bengio, Moritz Hardt, Benjamin Recht and Oriol Vinyals (2017). Understanding deep learning requires rethinking generalization. International Conference on Learning Representations.
- 15: Mikhail Belkin, Daniel Hsu, Siyuan Ma and Soumik Mandal (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. Proceedings of the National Academy of Sciences 116(32), 15849–15854.
- 16: Preetum Nakkiran, Gal Kaplun, Yamini Bansal, Tristan Yang, Boaz Barak and Ilya Sutskever (2020). Deep double descent: where bigger models and more data hurt. International Conference on Learning Representations.