卷积网络:让网络自己学习滤波器
局部性与权重共享、通道、感受野、一个完整的分类器,以及一个学成 Sobel 滤波器的卷积核。
第 2 篇让一个小卷积核(例如 Sobel 边缘核)在照片上滑动来计算图像特征,并指出每个卷积核都得靠人来设计。第 3 篇算过另一种做法的代价:把那张照片的 135,300 个像素送进一个全连接层,100 个隐藏单元就需要 1300 多万个参数。第 9 篇则说卷积层是图像上最强的正则化手段。本文把这三件事都讲清楚。卷积层是加了两条限制的全连接层:局部性和权重共享。这两条限制把参数从数百万个减到几百个,并把图像所具有的一个性质直接构建进去。它的权重就是第 2 篇的卷积核,只不过是学出来的。我们从一个一维例子推导出这种层,再推广到多通道的图像,追踪远处像素的信息如何到达深层,搭建一个完整的分类器并列出它的形状和开销,最后看一个卷积核如何通过学习变成 Sobel 滤波器。
1. 图像的两个性质
图像的两个事实决定了这种设计。第一是局部性:一个像素是否位于边缘上、是否在猫的胡须上,主要取决于它的邻居,而不是图像另一侧的像素。第二是平移:胡须出现在哪里看起来都一样,所以在左上角有效的检测器,在任何位置都应当有效。
全连接层对这两点都视而不见。每个隐藏单元对每个像素都有自己的权重,所以它必须从数据中分别学到:远处的像素关系不大,同一个图案在每个位置含义相同。无论有 20 张还是一百万张训练图像,这种学习都有很大一部分是浪费。
第二个性质可以精确表述。设 是对输入的一种变换,例如把图像平移几个像素。如果 ,即输出不变,就称函数 对 不变。如果 ,即对输入做变换就相当于对输出做同样的变换,就称 对 等变。图像分类器应当对平移大致不变,因为平移后的猫仍然是猫。计算特征图的层(例如每个像素处的边缘强度)应当等变,因为猫移动时,它的边缘应当跟着移动。下面将说明,卷积对平移是严格等变的。
2. 一维卷积
我们从一维输入开始,比如一段很短的音频信号,有六个值 。图像留到第 4 节。卷积核大小为 3 的卷积层,在每个位置 计算:
这个式子可以分成三部分。三个权重 作用于位置 及其左右两个邻居上的输入;加上一个偏置 ;并且每个位置都使用同样的这四个参数。在两端, 和 并不存在,我们把它们当作零,这称为零填充。用文字说:这一层让一个小的加权和沿着输入滑动,与第 2 篇式 2.1 的卷积核完全一样。和第 2 篇一样,严格说这是互相关,但深度学习称之为卷积。
取输入 、卷积核 、。这个卷积核计算右邻居与左邻居之差,是 Sobel 核一行的一维版本。位置 1 的输出是 ;位置 2 是 ;依此类推,得到 (图 10.1a)。信号上升处输出为正,下降处为负。在这一层后接 ReLU,,只保留上升部分:它是一个“上升”检测器。
现在把输入右移一位,。输出为 :同样的值,右移了一位(图 10.1b)。这就是等变性,而且对任何卷积核都成立,因为每个位置使用相同的权重。远离两端处它严格成立;在两端,零填充会稍微破坏它。
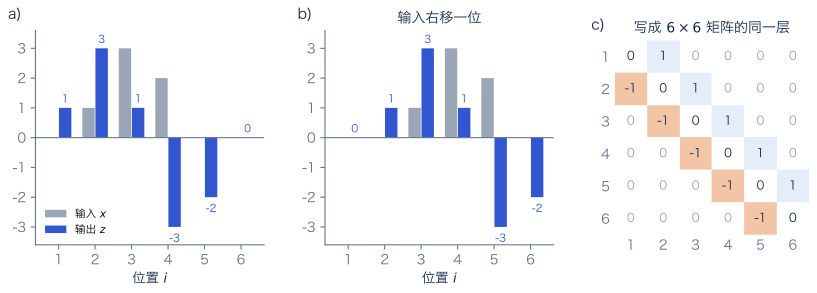
图 10.1 一维卷积。 a)输入 (灰色),以及用卷积核 、零填充时式 10.1 的输出(蓝色):。b)把输入右移一位,输出也右移一位。c)把同一层写成全连接层:一个 权重矩阵,除三条对角线外都是零,每条对角线重复一个卷积核权重。
卷积是受限的全连接层
六个输入到六个输出的全连接层计算 ,权重矩阵为 ,有 36 个权重和 6 个偏置。式 10.1 是它的特例。 的第 行是输出 给各输入的权重,对卷积而言,第 列是 ,第 列是 ,第 列是 ,其余为零(图 10.1c)。两条限制把一般矩阵变成了这个矩阵:
- **局部性:**离对角线超过一列的元素全为零。每个输出只依赖附近的输入。
- **权重共享:**每条对角线上的元素相等。每个位置使用相同的权重。
只有局部性时还剩 16 个自由权重;共享把它们减到 3 个,把 6 个偏置减到 1 个。卷积层能算的,全连接层都能算,反之则不然。限制正是关键所在:它在训练开始之前,就排除了区别对待不同位置、或直接连接远处输入的那些函数,训练数据不必再去排除它们。这就是第 9 篇称卷积为正则化手段的原因。
卷积核大小、步幅、填充与膨胀
一维卷积由四个超参数描述:
- 卷积核大小 ,即权重个数(上例为 3);
- 填充 ,即两端各补多少个零(上例为 1);
- 步幅 ,即卷积核在相邻两个输出之间移动的距离(上例为 1); 时只计算每隔一个位置的输出;
- 膨胀 ,即卷积核读取的输入之间的间隔: 时,大小为 3 的卷积核读取 ,跨越 5 个位置。
长度为 的输入产生的输出长度为
其中 表示向下取整。分子是卷积核的跨度可以移动经过的位置数,除以步幅就是实际用到的个数。对我们的输入,、:、 时输出长度为 6,与上面相同; 时为 3;不填充时为 4;、膨胀为 2 时为 4。
3. 卷积层的反向传播
训练卷积层需要损失对其权重和输入的梯度。第 2 节说明了这一层就是一个矩阵特殊的全连接层,所以第 8 篇已经回答了这个问题;不过权重共享让答案有一个有用的形式。
权重。 权重 在每个位置都被使用,所以由式 8.5,它的梯度是对所有使用的求和。在位置 ,它乘的是 ,而损失对该输出的导数是 :
用文字说:每个卷积核权重的梯度,是误差信号与按该权重偏移量平移后的输入之间的相关。对我们的输入,取误差信号 ,梯度为 ,,。每个位置都对每个权重有贡献,所以一个卷积核同时从所有训练图像的所有位置学习。这从另一个角度说明了卷积层为什么需要的数据少得多。
输入。 由式 8.8,对输入的梯度是 。把图 10.1c 的带状矩阵转置,得到另一个带状矩阵,其对角线上是倒序的卷积核,所以反向计算本身也是一次卷积,用的是翻转后的卷积核 。对我们的例子,结果为 。深度学习库把这两个梯度都实现为卷积,因此卷积层反向计算的开销与全连接层一样,约为前向计算的两倍。
4. 通道与二维卷积
图像有两个空间维度和若干通道:彩色照片有三个(红、绿、蓝),网络内部的特征图则多得多。一层通常也输出许多通道,每个通道有自己的卷积核,这样可以同时检测多种图案。
设输入有 个高为 、宽为 的通道,记为 。一个有 个输出通道、卷积核为 的二维卷积层,对输出通道 在位置 计算:
其中 ,对奇数 使卷积核以 为中心。这个式子可以分成三部分。里面两重求和是在一个输入通道内、 周围的 加权和,与第 2 篇相同。外层求和把所有输入通道的结果相加,所以一个输出通道会把红、绿、蓝等通道组合起来。最后,每个输出通道有自己的卷积核(一个 的权重块)和自己的偏置。用文字说:每个输出通道是一个学习得到的检测器,它跨所有输入通道观察一个小邻域,并在每个位置上使用。
权重构成形状为 的四维数组 ,所以这一层有
个参数,与图像大小无关。从 3 个颜色通道到 64 个通道的 层有 个参数;从 64 到 128 个通道的有 个。作为对比,从一张 彩色图像到同样高宽、64 个通道的输出,全连接层需要约 个权重。
计算量则取决于图像大小:每个输出通道的 个位置中,每一个都需要 次乘加。在 的图像上,64 个输入通道、64 个输出通道的 层需要 次乘加。所以卷积网络参数少,但每个参数对应的计算量很大,这与全连接网络正好相反,后者每个权重对每个样本只用一次。
每个样本的激活值存为形状 的数组,一批数据再加上最前面的一维:。 卷积()是值得一提的特例:它在每个位置上独立地对通道向量施加同一个全连接层。它混合通道而不看邻居,用来低成本地改变通道数。
5. 感受野与下采样
卷积核只能看到 的小块。要认出一只猫,网络最终必须综合图像大部分区域的信息。它靠叠加多层来做到这一点,并在途中缩小特征图。
感受野
一个单元的感受野是输入中能够影响它的区域。第一个 层中的单元,感受野是 。第二个 层中的单元看到第一层的一个 块,其中每个单元又看到 个像素,合起来覆盖 个像素。每增加一个步幅为 1 的层,每个维度上增加 个像素,所以 个这样的层的感受野为 :随深度线性增长。
下采样让它增长得更快。如果某层步幅为 ,之后每一层的步长在输入像素中都放大 倍。记 为第 层相邻单元之间在输入像素中的距离(),感受野 按下式增长:
其中 和 是第 层的卷积核大小和步幅。用文字说:每一层把感受野扩大“卷积核大小减一”,单位是它从前面各层继承来的步长。图 10.2 在一维中追踪了这一过程:两个 卷积得到 5,一个大小为 2、步幅为 2 的最大池化得到 6 并把步长加倍,下一个卷积增加 ,得到 10。
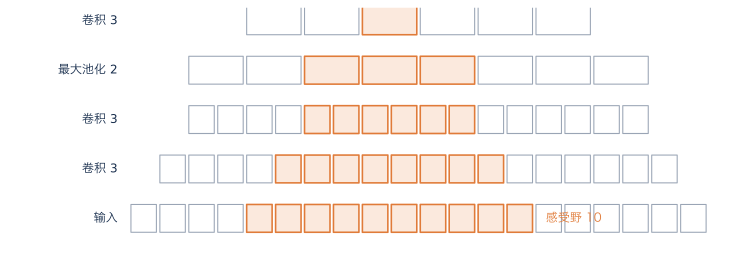
图 10.2 感受野如何增长。 一维的层堆叠:从输入(底部)经过两个卷积核大小为 3 的卷积、一个大小为 2 且步幅为 2 的最大池化,再经过一个卷积(顶部)。每一排中高亮的方格,是能影响顶排高亮单元的那些单元。每个卷积让感受野增加 2,池化增加 1,之后的卷积增加 4,因为池化之后每一步覆盖两个输入位置(式 10.5)。
有两点补充能让这个图景更准确。感受野是能够影响一个单元的区域;在训练好的网络中,影响集中在中心附近,向边缘逐渐减弱,所以有效感受野更小 [11]。另外,叠加小卷积核比用大卷积核更经济:两个 层与一个 层的感受野同为 ,但每对通道只用 个而不是 25 个权重,还多了一个非线性。正是这个理由让 卷积核成为标准 [7]。
池化与带步幅的卷积
大小为 2、步幅为 2 的最大池化把每个通道分成 的块,每块只保留最大值,使高和宽减半、数值个数减为四分之一。对下面的块:
平均池化则保留均值。池化没有参数。取最大值使得特征在块内移动时输出不变,这是对平移的少量不变性。带步幅的卷积即 的卷积,在下采样的同时学习如何组合数值,许多现代网络用它代替池化。在分类器末端,全局平均池化把每个通道在所有位置上取平均,把 的数组变成 个数的向量,不再依赖任何东西的位置。
像第 1 篇的分割这样需要逐像素输出的任务,必须把特征图放大回输入的大小。转置卷积用学习得到的权重做到这一点;它是带步幅卷积所对应矩阵的转置,正如第 3 节的反向计算一样。U-Net [12] 等编码器–解码器网络先下采样以获取上下文,再上采样回去,并用跳跃连接把早期层的细节送到后面的层。
6. 一个完整的分类器
现在为 10 类、 的彩色图像搭建一个小网络,这正是 CIFAR-10 基准的规模。它有三个阶段。每个阶段有两个填充为 1 的 卷积,各接一个 ReLU,然后是一个 最大池化;每个阶段把通道数加倍,池化把高和宽减半。最后用全局平均池化和一个全连接层输出 10 个分数:
| 层 | 输出形状 | 参数 | 乘加次数 | 感受野 |
|---|---|---|---|---|
| 输入 | 1 | |||
| 卷积 ,3 → 32 | 896 | 884,736 | 3 | |
| 卷积 ,32 → 32 | 9,248 | 9,437,184 | 5 | |
| 最大池化 | 0 | 6 | ||
| 卷积 ,32 → 64 | 18,496 | 4,718,592 | 10 | |
| 卷积 ,64 → 64 | 36,928 | 9,437,184 | 14 | |
| 最大池化 | 0 | 16 | ||
| 卷积 ,64 → 128 | 73,856 | 4,718,592 | 24 | |
| 卷积 ,128 → 128 | 147,584 | 9,437,184 | 32 | |
| 最大池化 | 0 | 36 | ||
| 全局平均池化 | 128 | 0 | 整幅图像 | |
| 全连接,128 → 10 | 10 | 1,290 | 1,280 | 整幅图像 |
| 合计 | 288,298 | 38,634,752 |
这张表展示了卷积网络的典型形态。空间尺寸从 缩小到 ,通道数则从 3 增长到 128:网络用“在哪里”换取“是什么”。参数集中在通道多的后几层,而计算量分布均匀,因为每个阶段面积减半、通道加倍。到最后一个卷积时,感受野 32 已经覆盖整幅图像。整个网络有 288,298 个参数。从 3,072 个输入值出发的全连接层,只要 94 个隐藏单元就会达到这个数,后面还一层都没有。
实际网络在更大规模上遵循同样的模式。1998 年的 LeNet-5 [3] 用约 6 万个参数识别手写数字。AlexNet [4] 在 2012 年 ImageNet 竞赛中获胜,开启了计算机视觉中的深度学习时代,它有约 6000 万个参数,大部分在最后的全连接层。VGG-16 [7] 由堆叠的 卷积构成,约有 1.38 亿个参数。第 11 篇介绍随后出现的残差网络 [6],它们更深,但借助全局平均池化和 卷积,规模小得多。
7. 学习一个滤波器
卷积网络的卷积核与其他参数一样,通过对损失做梯度下降来训练。一个小实验能展示卷积核的学习过程,也能说明为什么这可能很慢。
我们取第 2 篇的灰度猫照片(像素值在 0 到 1 之间),让单个卷积层(一个 卷积核加一个偏置)在每个位置上复现 Sobel 核 的输出。训练数据是卷积核能完整放进图像的 133,802 个位置,损失是该层输出与 Sobel 输出之间的均方误差。这是一个玩具实验:真实网络是用标签训练的,而不是用一个已知滤波器的输出。但它把单个卷积核的学习单独拿了出来。我们从随机权重出发,用最大的稳定学习率做全批量梯度下降。
图 10.3 是结果。卷积核确实精确收敛到了 Sobel 核,但很慢:100 步后看上去仍是随机的;1,000 步后出现了左右结构;10,000 步后损失为 0.00016,卷积核已经接近;100,000 步后权重与 在小数点后两位上一致。
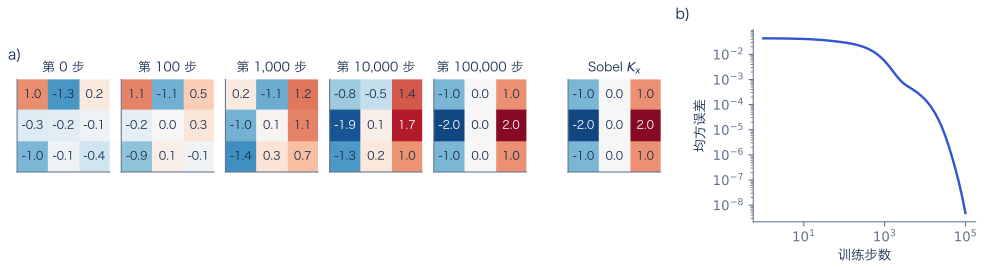
图 10.3 一个卷积核学成 Sobel 滤波器。 用梯度下降训练单个 卷积核(带偏置),使其在第 2 篇的灰度猫照片上复现 Sobel 输出 。a)初始时以及 100、1,000、10,000、100,000 步后的卷积核,旁边是 Sobel 核;红色为正,蓝色为负。b)训练过程中的均方误差。卷积核最终精确达到 Sobel 权重,但需要数万步。
慢的原因与第 9 篇对提前停止的分析相同。损失是十个参数的二次函数,而它在不同方向上的曲率差别极大:二阶导数矩阵的最大特征值为 5.99,最小为 0.00026,相差 23,000 倍。高曲率方向是卷积核的总和,它乘的是每个小块的平均亮度。低曲率方向是相邻权重之间的差,它们乘的是相邻像素之间的差,而在自然图像中相邻像素几乎相等。学习率小到能在陡峭方向上保持稳定,在平坦方向上的进展就会慢约 23,000 倍。不巧的是,平坦方向恰恰是检测边缘的方向。从图像中减去平均亮度可以把比值降到约 7,700,但不能消除问题,因为问题来自相邻像素之间的相关,而不是它们的均值。
这是实际训练使用 Adam 等自适应优化器(对每个方向分别缩放)和归一化层(第 11 篇,让每一层的输入保持居中和合适的尺度)的原因之一。它也解释了关于训练好的网络的一个观察:大型图像分类器第一层的卷积核往往像有方向的边缘检测器和色块 [4]、[9]。去掉整体亮度之后,边缘正是图像之间的区别所在,用好的优化器训练足够久的网络会找到它们。
8. 卷积网络学到了什么,又有哪些不足
对训练好的网络的可视化 [9]、[10] 显示出随深度的递进。前面的层响应边缘和颜色对比,中间的层响应纹理和简单形状,后面的层响应物体的部件,如眼睛、车轮或文字,乃至整个物体。这种层次不是谁规定的,而是从带标签的训练中涌现出来的,它是第 2 篇人工设计流程的“学习版”。这是对典型网络学到什么的经验描述,不是保证。
有三个局限值得了解。
平移不变性只是近似的。 卷积对平移是等变的,但步幅和池化在粗网格上对特征图采样,平移一个像素就可能让某个特征跨过块的边界。训练好的分类器可能因为图像平移了一个像素而改变预测 [13]。像经典信号处理那样在下采样前先做模糊,可以减弱这种效应 [14]。
重纹理而轻形状。 在 ImageNet 上训练的网络比人更依赖纹理:给它看一张形状是猫、纹理是大象皮的图像,它往往回答“大象” [15]。网络学到什么,取决于训练数据中什么能预测标签,而不是人认为什么是决定性特征。
对抗样本。 对图像做小到人察觉不到的改动,只要沿着损失对输入的梯度方向选取(第 3 节说明了如何计算它),就能把网络的预测改成几乎任何类别 [16]。这种敏感性并非卷积网络独有,其原因也尚未完全弄清。
9. 术语
- 卷积层执行式 10.4。它的卷积核也叫滤波器,是它学到的权重;每个输出通道有一个。
- 一个通道在每个位置上的输出构成一张特征图。数组的通道是它的第一个维度;彩色图像有三个。
- 填充、步幅和膨胀控制卷积核在哪里施加(式 10.2)。
- 单元的感受野是能影响它的输入区域(式 10.5)。
- 池化层(最大、平均、全局平均)不带参数地汇总一块数值。下采样减小高和宽;上采样(例如用转置卷积)增大它们。
- 卷积神经网络(convolutional neural network,CNN)是主要由卷积层构成的网络,用于分类时通常以全局池化和全连接层结束。
小结
卷积层是受两条限制的全连接层:每个输出只依赖输入的一个小邻域,并且每个位置使用相同的权重。这种限制把参数从数百万个减到几百个,把对平移的等变性构建进来,并让每个卷积核从每张图像的每个位置学习。它的梯度本身也是卷积。有多个输入和输出通道时,每个输出通道是一个跨所有输入通道施加的、学习得到的检测器。叠加多层使感受野变宽,池化或带步幅的卷积让它变宽得更快,同时用空间分辨率换取更多通道。完整的分类器遵循这一模式,并以全局平均池化结束。卷积核通过梯度下降学习;在自然图像上,由于相邻像素高度相关,类似边缘的方向学得很慢,这是使用自适应优化器和归一化的动机之一。训练好的网络学到从边缘到物体的层次,但它对平移的不变性只是近似的,而且可能依赖人不会使用的线索。第 11 篇说明如何训练有数百层的这类网络。
注释
历史。 福岛邦彦的 Neocognitron [2](1980)受视觉皮层启发,堆叠了带下采样的局部、共享特征检测器层,但不是用梯度下降训练的。LeCun 等人用反向传播训练卷积网络来识别手写邮政编码 [5],后来又用于识别银行支票上的数字 [3]。Krizhevsky、Sutskever 和 Hinton [4] 2012 年在 ImageNet 上的成果,结合了大型卷积网络、ReLU 激活、dropout、数据增强和 GPU 训练。
卷积的算术。 Dumoulin 和 Visin [8] 用图示说明了填充、步幅、膨胀和转置卷积如何相互作用,每种情形都有示意图。
其他维度与数据。 一维卷积处理音频和其他时间序列,三维卷积处理视频和医学体数据。图的节点没有固定的邻居网格,需要另一种推广(图神经网络)。Transformer(第 12 篇)完全去掉了局部性,让每个位置关注所有其他位置;用于图像时,它需要大数据集或强数据增强来弥补失去的限制。
延伸阅读。 Understanding Deep Learning [1] 第 10 章讲解了一维和二维数据上的卷积网络,包括第 1 节关于不变性与等变性的论证。
练习
练习 10.1 用零填充,把卷积核 作用于 。输出检测到了什么?(答案:。在信号内部,只有从 2 跳到 5 的台阶附近不为零;两端的值来自零填充。)
练习 10.2 从 16 个通道到 32 个通道的 卷积层有多少个参数?在 的输出上需要多少次乘加?(答案:;。)
练习 10.3 用式 10.2,长度为 32 的输入在 、、 时输出长度是多少?(答案:。)
练习 10.4 计算四个步幅为 1 的 卷积的感受野,以及“卷积 3、步幅为 2 的卷积 3、卷积 3、卷积 3”这一序列的感受野。(答案:9;第二种情况 ,因为带步幅的层之后每一步覆盖两个像素。)
练习 10.5 对输入 和误差信号 ,用式 10.3 计算三个卷积核权重的梯度。(答案:,,。)
练习 10.6 证明当填充采用循环方式(即 、)时,在每个位置施加式 10.1 的层对循环平移是等变的。(提示:把平移后的输入写成 ,下标按模 6 取,再代入式 10.1。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Kunihiko Fukushima (1980). Neocognitron: a self-organizing neural network model for a mechanism of pattern recognition unaffected by shift in position. Biological Cybernetics 36(4), 193–202.
- 3: Yann LeCun, Léon Bottou, Yoshua Bengio and Patrick Haffner (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE 86(11), 2278–2324.
- 4: Alex Krizhevsky, Ilya Sutskever and Geoffrey Hinton (2012). ImageNet classification with deep convolutional neural networks. Advances in Neural Information Processing Systems 25.
- 5: Yann LeCun, Bernhard Boser, John Denker, Donnie Henderson, Richard Howard, Wayne Hubbard and Lawrence Jackel (1989). Backpropagation applied to handwritten zip code recognition. Neural Computation 1(4), 541–551.
- 6: Kaiming He, Xiangyu Zhang, Shaoqing Ren and Jian Sun (2016). Deep residual learning for image recognition. IEEE Conference on Computer Vision and Pattern Recognition.
- 7: Karen Simonyan and Andrew Zisserman (2015). Very deep convolutional networks for large-scale image recognition. International Conference on Learning Representations.
- 8: Vincent Dumoulin and Francesco Visin (2016). A guide to convolution arithmetic for deep learning. arXiv:1603.07285.
- 9: Matthew Zeiler and Rob Fergus (2014). Visualizing and understanding convolutional networks. European Conference on Computer Vision.
- 10: Chris Olah, Alexander Mordvintsev and Ludwig Schubert (2017). Feature visualization. Distill.
- 11: Wenjie Luo, Yujia Li, Raquel Urtasun and Richard Zemel (2016). Understanding the effective receptive field in deep convolutional neural networks. Advances in Neural Information Processing Systems 29.
- 12: Olaf Ronneberger, Philipp Fischer and Thomas Brox (2015). U-Net: convolutional networks for biomedical image segmentation. Medical Image Computing and Computer-Assisted Intervention.
- 13: Aharon Azulay and Yair Weiss (2019). Why do deep convolutional networks generalize so poorly to small image transformations? Journal of Machine Learning Research 20(184), 1–25.
- 14: Richard Zhang (2019). Making convolutional networks shift-invariant again. International Conference on Machine Learning.
- 15: Robert Geirhos, Patricia Rubisch, Claudio Michaelis, Matthias Bethge, Felix Wichmann and Wieland Brendel (2019). ImageNet-trained CNNs are biased towards texture; increasing shape bias improves accuracy and robustness. International Conference on Learning Representations.
- 16: Christian Szegedy, Wojciech Zaremba, Ilya Sutskever, Joan Bruna, Dumitru Erhan, Ian Goodfellow and Rob Fergus (2014). Intriguing properties of neural networks. International Conference on Learning Representations.