残差网络与归一化:训练非常深的网络
普通深层网络为何退化,跳跃连接与归一化如何解决,以及它们各自对信号的作用。
第 7 篇说明深度能让网络的表达能力大大增强,第 8 篇推导了在训练开始时让信号保持合适大小的初始化方法。然而到 2015 年,能训练好的最深网络大约只有二十层。给普通卷积网络再加层,结果反而更差,连在训练数据上也是如此。本文解释其原因,并介绍打破这一限制的两个想法:残差连接,把每一层的输出加到它的输入上;归一化层,在网络内部重新调整激活值的尺度。两者结合,让上百层的网络成为常规,它们也是几乎所有现代架构的组成部分,包括第 12 篇的 Transformer。我们推导它们各自对前向信号和梯度的作用,用模拟验证这些推导,并把关于它们已被证明的结论与仅仅是观察到的现象区分开来。
1. 更深并不自动更好
He 等人在 CIFAR-10 图像上训练了 20 层和 56 层的普通卷积网络 [2]。56 层网络的误差比 20 层的高,在测试集上如此,在训练集上也是如此。训练误差更高,就排除了过拟合(第 9 篇)这一解释。这也不是表示能力的问题:更深的网络只要把多出来的层设为恒等映射,就能模仿较浅的网络,所以它可能达到的最低训练误差不会更高。更深的网络只是更难优化。他们称之为退化问题。
仅靠初始化治不了它。He 初始化(第 8 篇)让激活值和误差信号的大小平均保持不变,但随机矩阵的长串乘积仍会把梯度所携带的信息打乱。观察梯度如何随输入变化,是看清这一点的一种方式。图 11.1 画出了三个单输入、单输出网络的导数 随输入沿一条直线移动时的变化。对浅层网络,导数是 的简单函数:相邻的输入梯度相近。对 100 层的普通网络,它看起来像噪声。对十个随机网络取平均,直线上相邻两点导数之间的相关系数,浅层网络为 0.98,24 层、50 层、100 层的普通网络则依次降到 0.90、0.70 和 0.50。Balduzzi 等人称之为破碎梯度问题 [9]。如果某个输入处的梯度对附近输入处的梯度几乎没有提示作用,那么在一批样本上算出的梯度步,对附近的输入来说就是很差的指引,训练进展缓慢。
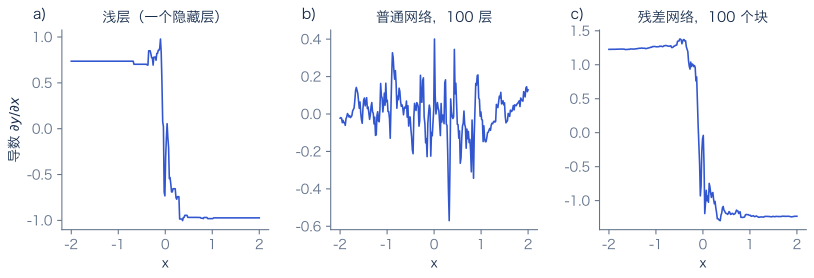
图 11.1 破碎梯度。 三个随机初始化、宽度为 100、标量输入和输出的 ReLU 网络,在 到 2 之间 256 个输入上的导数 。a)浅层网络:导数随 平滑变化。b)100 层、He 初始化的普通网络:某个输入处的导数与相邻点几乎无关(相邻点相关系数 0.50,十个网络的平均)。c)100 个块的残差网络(第 2 节):浅层网络的结构得以保留(相关系数 0.97)。
图 11.1 的第三幅显示了保住这种结构的网络:一个 100 个块的残差网络。下面介绍它。
2. 残差连接
残差块计算其输入的一个函数 ,即残差分支,再把结果加到输入上:
分支 是一个小网络,通常是中间夹一个激活函数的两层,它的输出必须与输入形状相同,二者才能相加。把 绕过分支传过去的连接称为跳跃连接或捷径。用文字说:每个块计算一个修正量并加到收到的东西上,而不是替换它。如果分支输出为零,这个块就是恒等映射;因此由这种块组成的深层网络,可以表示删掉其中任意几个块所得到的较浅网络,这正是退化问题中似乎缺少的性质。
展开残差网络
把一个块代入下一个块,就能看出残差网络在计算什么。三个块、输入为 时:
每个块都可以经过或跳过,所以从输入到输出共有 条路径,长度为 0、1、2、3 个块,各有 条。有 个块的网络有 条路径,经过 个块的路径有 条:大多数路径的长度约为网络深度的一半。相比之下,普通网络只有一条穿过所有层的路径。
梯度总有一条直达路径
由式 11.1 可得一个块的输出对其输入的导数:
其中单位矩阵 来自跳跃连接,第二项是分支的雅可比矩阵。反向传播经过 个块时要把这些矩阵相乘(第 8 篇,式 8.12),把乘积展开得到
式 11.2 的每条路径对应其中一项(矩阵乘积的顺序与块的顺序一致)。第一项是单位矩阵:无论分支做什么,输出端的误差信号都能原封不动地直接到达每个块。相比之下,普通网络中只有所有层雅可比矩阵的乘积这一项。
用标量数字可以把区别说得很具体。在一条 20 层的普通链中,如果每层导数都是 0.5,乘积为 ;都是 0.9 时为 0.12,都是 1.1 时为 6.7。每个因子都必须非常接近 1,乘积才能保持可用。在残差链中,因子是 ,其中 是分支的导数。20 个块的 都取 时,乘积为 ;都取 时为 。分支只需要小,不需要精确调好。如果把它们初始化为恰好为零,网络一开始就是首层与末层之间的恒等映射,训练起来毫无困难,训练再从这里逐渐让每个分支长大。
3. 残差网络的方差
式 11.1 有一个代价。每个块都把分支的输出加到信号上,所以信号会增长。在初始化时,如果每个分支最后一层的权重独立抽取、均值为零,分支输出就与 不相关,方差相加:
如果分支的初始化让它保持输入的大小(He 初始化对每一层都是这样做的),那么 ,每经过一个块方差大约翻一倍:50 个块后增长约 倍。残差网络用一个爆炸的和,换掉了普通网络中消失的乘积。
图 11.2 用模拟验证这一点:50 个宽度为 100 的块,每个分支是两层 He 初始化的 ReLU 层,输入是一批 256 个随机样本。不做任何修正时(橙色),方差在 1 个块后为 2.0,10 个块后为 1,490,50 个块后为 。实践中有三种补救办法,图中展示了其中两种:
- **缩放分支。**把每个分支乘以 ,使它只增加当前方差的 ,于是 。模拟中 50 个块后为 2.6(绿色)。
- 把每个分支初始化为零,即把它最后一层的权重或最后一个归一化层的缩放系数设为零 [10]。网络一开始就恰好是恒等映射,初始化时方差保持不变。
- **对分支的输入做归一化。**如果每个分支以一个归一化层开头(第 4 节),它的输入方差总是 1,所以它增加的方差大致恒定,总方差只随深度线性增长:1 个块后为 2.1,50 个块后为 48(蓝色)。于是每个新分支相对于它所加上去的信号都很小,这使各个块在初始化时偏向恒等映射 [11]。
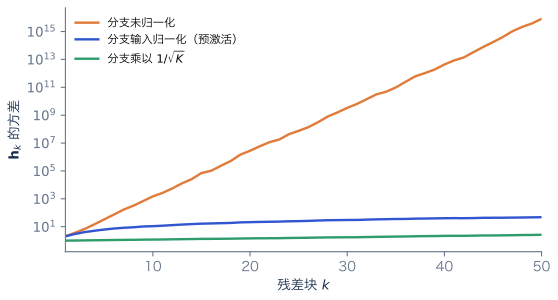
图 11.2 信号经过 50 个残差块时的方差。 每个块加上一个两层、He 初始化的 ReLU 分支的输出(宽度 100,一批 256 个随机输入)。橙色:分支未归一化;方差每个块大约翻倍(式 11.5)。蓝色:每个分支以批归一化开头,所以每次增加的量大致恒定,方差线性增长。绿色:每个分支乘以 ,方差只增长约 倍。注意纵轴是对数刻度。
4. 批归一化
归一化层在网络内部重新调整激活值的尺度。第一种、也是影响最大的一种是批归一化 [3]。它对每个隐藏单元(在卷积网络中是每个通道)分别处理,使用该单元在当前批的 个样本上的值。对预激活为 的一个单元,它计算:
这可以分成三步。第一,计算该单元在这一批上的均值和方差。第二,减去均值、除以标准差,使归一化后的值 在批内均值为 0、方差为 1;小常数 (如 )用来避免除以零。第三,用每个单元两个可学习的参数 和 做缩放和平移,使这一层仍能表示网络所需的任何均值和方差,包括撤销归一化。在卷积网络中,一个通道的均值和方差是对批和所有位置一起计算的,这样每个位置都被同样对待。
例如,一个单元在四个样本组成的批中预激活为 ,均值为 5,方差为 。归一化后的值为 ;取 、,输出为 。用文字说:无论前面的层做了什么,批归一化都让每个单元在一批中的值具有受控的均值和离散程度。
预测时可能只有一个样本,所以批统计量换成训练期间累积的 和 的滑动平均。这一层于是成为一个固定的仿射函数,可以并入前面的权重。由于 起到了偏置的作用,批归一化层之前的那一层不需要自己的偏置。
反向计算
批统计量依赖批中的每个样本,所以每个样本的梯度都依赖其他样本。记 ,经由 和 应用链式法则(忽略 ),得到
用文字说:从传入的梯度中去掉它在批上的均值,以及它沿归一化值方向的分量,再除以标准差。两次去除各有原因。给批中每个 加同一个常数,或都乘以同一个正数, 都不变,所以损失不可能依赖这两个方向,梯度在这两个方向上也就没有分量。对 和 ,式 11.7 给出 ,它的和为零、与 正交,并且与有限差分一致。
它为什么有用
批归一化让网络训练得更快、能用更大的学习率、对初始化也不那么敏感,很快被广泛采用。它为什么有效,远不如它有效这一点那样确定。有四种机制得到了较好的支持:
- 它在每一层控制激活值的尺度,训练期间和初始化时都是如此,从而消除了第 3 节的方差增长,以及对初始化的大部分敏感性。
- **它让每一层对其权重的尺度不变。**如果输入某个归一化单元的权重 乘以 ,预激活也乘以 ,而式 11.6 会消去这个因子:输出不变。于是对 的梯度是对 的梯度的 倍,一次梯度步改变权重方向的幅度与 成正比。大的权重自动得到小的有效学习率;而缩小权重的权重衰减,会提高有效学习率 [12]。
- **它允许更大的学习率。**Santurkar 等人 [13] 发现,批归一化让损失及其梯度随参数移动而变化得更平滑,所以更大的步长仍能保持稳定。
- **它引入噪声。**每个样本用依赖于同批其他样本的统计量来归一化,这起到轻微的正则化作用(第 9 篇)。
原论文的解释——批归一化减少了内部协变量偏移(即随着前面的层被训练,每层输入分布的变化)——并没有得到很好的支持:Santurkar 等人在归一化层之后故意注入分布偏移,训练并未受到影响 [13]。
批归一化也有代价。它的表现依赖批大小:批小时统计量噪声大,准确率下降。训练和预测计算的是不同的函数,这是一些隐蔽错误的来源。而且同一批中的样本会相互影响彼此的输出,有些任务不允许这样。
5. 其他归一化
几种替代方法的区别在于哪些值放在一起归一化。对卷积层,一批激活值构成形状为 的数组。每种方法在其中一组值上计算均值和方差,并用它们归一化这一组(图 11.3):
| 方法 | 统计量的计算范围 | 依赖批吗? | 主要用途 |
|---|---|---|---|
| 批归一化 [3] | 一个通道,所有样本和位置 | 是 | 大批量的卷积网络 |
| 层归一化 [5] | 一个样本,所有通道(和位置) | 否 | Transformer、循环网络 |
| 组归一化 [6] | 一个样本,一组通道 | 否 | 小批量的卷积网络 |
| 实例归一化 [7] | 一个样本,一个通道 | 否 | 图像风格迁移 |
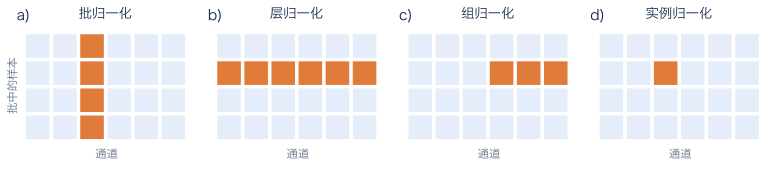
图 11.3 每种归一化使用哪些值。 每个方格表示一批 4 个样本(行)、6 个通道(列);每一格代表一个样本的一个通道的全部 个位置。橙色格子放在一起,用同一个均值和方差归一化。a)批归一化:一个通道跨整批。b)层归一化:一个样本的全部通道。c)组归一化:一个样本的一组通道。d)实例归一化:一个样本的一个通道。
一个小表可以说明区别。取一批四个样本,每个有三个特征,每行一个样本:
批归一化让每一列均值为 0、方差为 1;每个样本的输出依赖另外三个样本。层归一化让每一行均值为 0、方差为 1;每个样本单独归一化,所以训练和预测时计算同一个函数,适用于任何批大小,包括 1。正因为这种独立性,生成时常常一次只处理一个序列的 Transformer 使用层归一化。RMSNorm [8] 进一步简化了层归一化:不减均值,只除以均方根。第一行 变成 。它更便宜,在大型语言模型中效果相差无几。
6. 残差块的设计
残差的想法并没有规定分支里放什么、归一化和激活放在哪里。三种设计涵盖了大部分实践(图 11.4)。
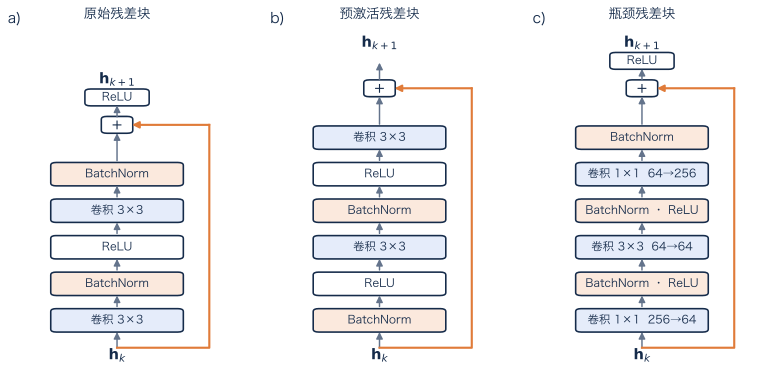
图 11.4 三种残差块。 橙线是跳跃连接。a)He 等人的原始残差块 [2]:两个 卷积,各接批归一化,相加之后再施加 ReLU。b)预激活残差块 [4]:归一化和 ReLU 放在每个卷积之前,相加之后什么也不做,所以跳跃连接在整个网络中构成一条干净的恒等路径。c)较深网络使用的瓶颈残差块: 卷积先把 256 个通道减到 64,供代价高的 卷积使用,之后再恢复。
原始残差块与预激活残差块。 在原始残差块中(图 11.4a),相加之后接一个 ReLU,所以传给下一个块的信号并不恰好是 。预激活残差块(图 11.4b)把归一化和激活移到分支内部。于是对任意两个块, 严格成立,式 11.4 中的恒等项不受影响。He 等人发现,这种设计训练 1,000 层的网络比原始设计更好 [4]。Transformer 也采用同样的模式,只是用层归一化(第 12 篇)。
瓶颈残差块。 由两个 256 通道的 卷积组成的块有 个权重。瓶颈残差块(图 11.4c)在 64 个通道上做 卷积,前后各有一个 卷积减少和恢复通道数,共有 个权重,少了 17 倍。由 16 个这样的块构成的 ResNet-50 约有 2560 万个参数,不到 VGG-16 的五分之一,而在 ImageNet 上更准确。
改变形状。 式 11.1 要求分支输出与输入形状相同。在网络下采样或改变通道数的地方,跳跃连接使用一个步幅为 2 的 卷积(投影捷径)使形状匹配。
相关设计。 高速公路网络 [14] 早于残差网络,使用带门控的跳跃连接,门是学习得到的。DenseNet [15] 把前面所有层的输出拼接起来,而不是相加。U-Net(第 10 篇)的跳跃连接把细节跨越整个网络传过去,而不是只绕过一个块。
7. 残差网络为什么有效
有三种解释得到了较好的支持,但没有一种是完整的。
恒等路径让梯度保持有用的信息。 这就是第 2 节的推导,它是精确的:式 11.4 中有一项把输出端的误差信号原封不动地送到每个块。图 11.1c 显示了它对第 1 节梯度破碎问题的影响:100 个块时相邻梯度的相关系数为 0.97,几乎与浅层网络相同。
残差网络的行为像较浅网络的集成。 Veit 等人 [16] 从经验上研究了式 11.2 中的路径。从训练好的残差网络中删掉单个块,准确率几乎不变;而从 VGG 这样的普通网络中删掉一层,网络就失效了,所以没有哪一条路径是必不可少的。在一个 110 层的残差网络中,训练时大部分梯度来自只有 10 到 34 层深的路径。这说明残差网络之所以能避开深度带来的困难,部分原因在于它并不依赖最长的路径。
损失曲面更平滑。 Li 等人 [17] 沿参数空间中的随机方向可视化了损失曲面。没有跳跃连接的深层网络曲面混乱,有许多尖锐的局部起伏;同样的网络加上跳跃连接后,训练找到的极小值附近的曲面平滑、近乎凸。这类可视化只是极高维曲面的低维切片,所以它们是例证而不是证明。
8. 术语
- 残差块计算 。 是残差分支,绕过它的连接是跳跃连接、捷径或恒等路径。由这种块构成的网络是残差网络(ResNet)。 的序列有时称为残差流。
- 预激活块在分支内每个权重层之前做归一化和激活;后激活块在之后做。
- 瓶颈块在代价高的层之前用 卷积减少通道数,之后再恢复。投影捷径是带 卷积、用来改变形状的跳跃连接。
- 批、层、组和实例归一化的区别在于放在一起归一化的值的集合(图 11.3)。RMSNorm 不减均值,只除以均方根。可学习的 和 分别是缩放和平移(或称增益和偏置)。
小结
层数很多的普通网络训练得比浅层网络差,连在训练数据上也是如此,因为梯度要穿过一长串层雅可比矩阵的乘积,被打乱了。残差连接把每个块的输出加到它的输入上。于是梯度中包含一个直达每个块的恒等项(式 11.4),网络的行为在一定程度上像较浅路径的集成。代价是方差在块与块之间相加,若不加处理,每个块大约翻一倍;缩放分支、把分支初始化为零或对分支输入做归一化,都能控制这一点。批归一化在批上对每个单元做标准化,再用可学习的参数重新缩放;它让激活值保持在合适的范围内,使每一层对其权重的尺度不变,允许更大的学习率,并带来一点正则化噪声,但原论文对其成功的解释并没有得到支持。层归一化对每个样本做同样的事,是 Transformer 的选择。有了这些工具,上百层甚至更深的网络都能可靠地训练。第 12 篇把残差连接和层归一化与一种新的层——注意力——结合起来,构建 Transformer。
注释
无归一化网络。 精心地初始化和缩放残差分支,可以完全取代归一化。Fixup [10] 把每个分支的最后一层初始化为零,并重新缩放其他层,无需归一化就能训练有数千层的残差网络。后来的工作使用缩放后的权重标准化和自适应梯度裁剪,在 ImageNet 上不用任何归一化层就达到了批归一化网络的准确率 [18]。
权重归一化。 也可以不归一化激活值,而是归一化权重:把每个权重向量写成长度乘以单位方向,两者分别学习。这在不依赖批的情况下,得到了第 4 节的尺度不变性 [19]。
实践中的深度。 残差连接让深度变得可训练,但深度并不因此免费。非常深的残差网络常常不如代价相同、更宽更浅的网络准确,最佳深度要靠实验确定。He 等人在 CIFAR-10 上训练了一个 1,202 层的网络;它拟合了训练集,但测试误差比他们的 110 层网络高,他们把这归因于过拟合 [2]。
延伸阅读。 Understanding Deep Learning [1] 第 11 章讲解了残差网络、第 3 节的方差分析、批归一化以及第 1 节的破碎梯度。
练习
练习 11.1 对 施加批归一化(,,)。与第 4 节的例子比较,并解释结果。(答案:均值为 4,方差为 5,所以输出仍是 ;输入是那个例子的输入减 1,而批归一化会消去任何平移。)
练习 11.2 有 4 个块的残差网络中有多少条路径?其中恰好经过两个块的有多少条?(答案:;。)
练习 11.3 证明在 时,对任意 和任意 ,批归一化对 的输出与对 的相同。(提示:均值变为 ,标准差变为 。)
练习 11.4 如果 10 个残差分支中每一个增加的方差都与其输入的方差相同,方差增长多少倍?如果每个分支乘以 呢?(答案:;。)
练习 11.5 对特征为 的一个样本施加层归一化(,,)。(答案:均值为 3,方差为 3.5,输出为 。)
练习 11.6 外层 512 个通道、内层 128 个通道的瓶颈残差块有多少个权重(不计偏置和归一化参数)?(答案:。)
练习 11.7 在一条有 100 个块、分支导数都等于 的标量残差链中,分别对 和 计算式 11.4 的乘积。(答案: 和 。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Kaiming He, Xiangyu Zhang, Shaoqing Ren and Jian Sun (2016). Deep residual learning for image recognition. IEEE Conference on Computer Vision and Pattern Recognition.
- 3: Sergey Ioffe and Christian Szegedy (2015). Batch normalization: accelerating deep network training by reducing internal covariate shift. International Conference on Machine Learning.
- 4: Kaiming He, Xiangyu Zhang, Shaoqing Ren and Jian Sun (2016). Identity mappings in deep residual networks. European Conference on Computer Vision.
- 5: Jimmy Lei Ba, Jamie Ryan Kiros and Geoffrey Hinton (2016). Layer normalization. arXiv:1607.06450.
- 6: Yuxin Wu and Kaiming He (2018). Group normalization. European Conference on Computer Vision.
- 7: Dmitry Ulyanov, Andrea Vedaldi and Victor Lempitsky (2016). Instance normalization: the missing ingredient for fast stylization. arXiv:1607.08022.
- 8: Biao Zhang and Rico Sennrich (2019). Root mean square layer normalization. Advances in Neural Information Processing Systems 32.
- 9: David Balduzzi, Marcus Frean, Lennox Leary, J.P. Lewis, Kurt Wan-Duo Ma and Brian McWilliams (2017). The shattered gradients problem: if resnets are the answer, then what is the question? International Conference on Machine Learning.
- 10: Hongyi Zhang, Yann Dauphin and Tengyu Ma (2019). Fixup initialization: residual learning without normalization. International Conference on Learning Representations.
- 11: Soham De and Samuel Smith (2020). Batch normalization biases residual blocks towards the identity function in deep networks. Advances in Neural Information Processing Systems 33.
- 12: Twan van Laarhoven (2017). L2 regularization versus batch and weight normalization. arXiv:1706.05350.
- 13: Shibani Santurkar, Dimitris Tsipras, Andrew Ilyas and Aleksander Mądry (2018). How does batch normalization help optimization? Advances in Neural Information Processing Systems 31.
- 14: Rupesh Kumar Srivastava, Klaus Greff and Jürgen Schmidhuber (2015). Training very deep networks. Advances in Neural Information Processing Systems 28.
- 15: Gao Huang, Zhuang Liu, Laurens van der Maaten and Kilian Weinberger (2017). Densely connected convolutional networks. IEEE Conference on Computer Vision and Pattern Recognition.
- 16: Andreas Veit, Michael Wilber and Serge Belongie (2016). Residual networks behave like ensembles of relatively shallow networks. Advances in Neural Information Processing Systems 29.
- 17: Hao Li, Zheng Xu, Gavin Taylor, Christoph Studer and Tom Goldstein (2018). Visualizing the loss landscape of neural nets. Advances in Neural Information Processing Systems 31.
- 18: Andrew Brock, Soham De, Samuel Smith and Karen Simonyan (2021). High-performance large-scale image recognition without normalization. International Conference on Machine Learning.
- 19: Tim Salimans and Diederik Kingma (2016). Weight normalization: a simple reparameterization to accelerate training of deep neural networks. Advances in Neural Information Processing Systems 29.