Transformer:对序列做注意力
手算自注意力、缩放、位置编码、多头注意力,以及对 GPT-2 参数的完整清点。
卷积网络(第 10 篇)适合图像,因为相邻像素最重要,同一个图案在哪里含义都相同。文本打破了这两个假设。在 “The cat that the dog chased all morning finally fell asleep” 这句话中,动词 “fell” 的主语是猫还是狗,取决于七个位置之前的词;而哪个更早的词重要,取决于内容,而不是固定的距离。文本的长度也各不相同,从几个词到整本书。全连接网络需要固定的输入大小,卷积只看固定的邻域,权重与相对位置绑定。本文介绍同时满足这三项要求的层——自注意力:每个位置对所有位置做加权平均,权重由它们的内容算出。我们用三个词元和具体数字算一遍自注意力,写出它的矩阵形式并推导其性质,解释实践中需要的缩放、位置信息和多个头,再把自注意力与第 11 篇的残差连接和层归一化组合成 Transformer。然后我们数一数一个真实模型 GPT-2 的参数,并说明 Transformer 如何被训练来为语言建模。
1. 把文本变成向量序列
Transformer 不读字符。文本先被切分成词元(token),即来自一个固定词表的单位,词表通常有 3 万到 10 万项。常用词是单个词元;罕见词被切成常见的片段,例如 “un”“believ” 和 “able”。这种子词切分 [4] 让有限的词表能表示任意字符串,同时保持常用词完整。接着每个词元被替换为一个可学习的、由 个数组成的向量,即它的嵌入。词表有 个词元时,嵌入构成矩阵 ,第 号词元映射为第 列。GPT-2 [6] 的 、,仅嵌入矩阵就有 38,597,376 个参数。嵌入与网络的其余部分一起训练。
于是 个词元的文本变成 个向量 ,每个大小为 。我们把它们作为矩阵 的各列,每个词元一列,与第 7、8 篇的约定一致。处理这种数据的层应当:
- 用同一组参数接受任意列数 ;
- 像卷积那样,用同一条规则对待每个位置;
- 让每个位置能从任何其他位置获取信息,并且选择哪些位置取决于它们的内容。
2. 自注意力:一个算例
自注意力为每个位置 计算一个新向量,它是由所有位置导出的向量的加权平均。我们从三个二维词元和具体数字开始。一般的矩阵形式留到第 3 节,并且暂时不加偏置。
三个输入向量是下面矩阵的各列:
即 、、。自注意力对每个词元施加三个不同的线性映射。查询 描述位置 在找什么。键 描述位置 能提供什么。值 是位置 被选中时贡献的内容。取
值矩阵取单位矩阵只是为了让算术简短:每个值就等于它的输入。查询为 、、,键为 、、。
这一层依次计算三样东西:
第一,为每一对位置计算分数 :位置 的键与位置 的查询的点积,两者方向相近时分数大。第二,对每个查询 ,在所有键 上做 softmax(第 4 篇),把分数变成注意力权重 ,它们为正,并且对 求和为 1。第三,位置 的输出是所有值按这些权重的加权平均。用文字说:每个位置提出一个问题,与每个位置所能提供的内容比较,再按匹配程度把它们的贡献混合起来。
代入我们的数字,以键为行、查询为列,分数为
对第一个查询, 的 softmax 给出权重 :位置 1 主要关注位置 3。第二个查询的分数 给出 ,在位置 2 和 3 之间平分。第三个给出 。输出是各个值的加权平均:位置 1 为 ;位置 2 和 3 分别为 和 。图 12.1a–b 显示了分数和权重。
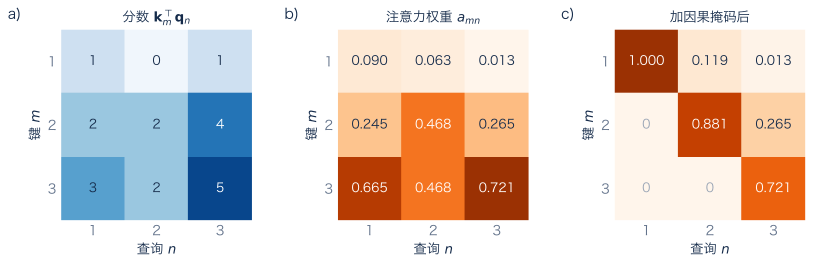
图 12.1 三个词元的自注意力。 行是键 ,列是查询 。a)第 2 节例子的分数 。b)注意力权重:对每一列做 softmax,所以每列之和为 1。每个位置都最关注键最大的位置 3。c)加上第 8 节因果掩码后的权重:每个查询只能关注它自己和之前的位置,所以位置 1 只关注自己。
从这个例子可以得到三点观察。分数矩阵不是对称的:位置 1 对位置 3 的关注()与 3 对 1 的关注()不同,因为查询和键使用不同的映射。权重是由输入算出的,所以尽管每个值对 是线性的,这一层对 却不是线性的:改变 ,值和混合它们的权重都会改变。而且式 12.1 中没有任何东西依赖 :第四个词元只会给 添一行一列,仍使用同样的三个矩阵。
3. 自注意力的矩阵形式
现在写出带偏置的一般层,处理 个维数为 的词元。所有位置的查询、键和值分别是三个矩阵的各列:
其中 ,, 是由 个 1 组成的向量,与式 7.8 相同。全部分数就是矩阵 ,其第 行第 列是 。对每一列做 softmax 并混合各个值,就得到整个层:
形状正确: 乘以 得到 ,每个位置一列输出。乘积的第 列是 ,即式 12.1。深度学习库通常把词元存为行,把同一计算写成转置形式 。
参数。 这一层有 个权重和 个偏置,与 无关。 时为 。
置换等变性。 重排词元,输出也以同样的方式重排。设 是置换矩阵,把 换成 ,则 、、 变为 、、(偏置项在每一列都相同)。分数变为 :行和列以同样方式重排。按列做的 softmax 与列内重排行、与重排各列都可交换,所以 ;由于 ,输出为 。这一层把输入当作一个集合:它不知道哪个词元在前。第 5 节会把这一信息补回来。
开销。 计算 、、 约需 次乘加,相当于对每个词元施加一个全连接层。分数需要 次,混合各个值再需要 次。注意力矩阵有 个元素,内存和计算量随序列长度的平方增长:文本长度加倍,注意力的开销变为四倍。序列短时 项占主导,序列长时 项占主导。
4. 缩放分数
当 很大时,式 12.3 有一个问题。设查询和键的各元素独立、均值为 0、方差为 1,这大致是初始化和归一化所给出的情形。那么分数 是 个独立项之和,每项均值为 0、方差为 ,所以
时,典型分数之间相差 8 左右,而对分布如此分散的数做 softmax,几乎把全部权重都给了最大的那个。饱和的 softmax 不只是表达能力的问题,也是训练的问题。它的导数是 ,当一个权重接近 1、其余接近 0 时,每个元素都接近零,于是几乎没有梯度能传回查询和键。
解决办法是把分数除以 ,恢复单位方差:
这就是缩放点积注意力 [2]。图 12.2 用 16 个键和单位方差的随机向量展示了效果。不缩放时,最大注意力权重的平均值在 时为 0.21, 时为 0.69, 时为 0.92, 时为 0.96:注意力变成了对一个键的硬选择。缩放后,对每个 它都保持在 0.21 到 0.25 之间。在第 2 节的算例中 ,缩放会把第二列从 软化为 。
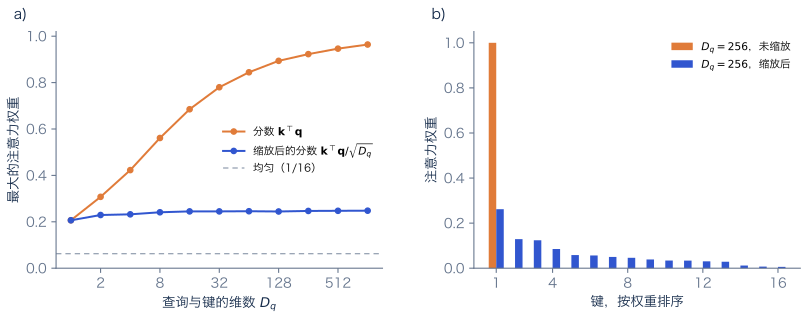
图 12.2 为什么要把分数除以 。 一个查询和 16 个键,元素独立地服从标准正态分布。a)随着维数 增大,16 个注意力权重中最大者的平均值(2,000 次抽样)。未缩放的分数方差为 (式 12.4),所以 softmax 集中到一个键上;缩放后权重保持分散。虚线是均匀权重 1/16。b) 的一次抽样:16 个权重从大到小排列,未缩放(橙色)与缩放后(蓝色)。
5. 位置
由于自注意力是置换等变的,“the dog chased the cat” 和 “the cat chased the dog” 会产生同样的输出,只是顺序不同。位置信息必须显式加入。常见的做法有三种。
绝对正弦编码。 原始的 Transformer [2] 给每个词元的嵌入加上一个只依赖其位置 的固定向量,其元素为
其中 。每对元素是一个频率各异的正弦和余弦,从 时每 个位置一个周期,一直到非常慢的频率。、位置为 1 时,编码为 。快的那几对区分相邻位置,慢的那几对区分远处的位置,就像钟表上的几根指针。
可学习的绝对嵌入。 GPT-2 则为直到最大长度的每个位置学习一个单独的向量,即第二个大小为 的嵌入矩阵(786,432 个参数)。它简单且效果好,但无法表示训练中见过的最大长度之外的位置。
通过旋转表示相对位置。 通常重要的是两个词元相距多远,而不是它们的绝对位置。旋转位置嵌入(RoPE)[7] 按位置旋转每个查询和键来做到这一点。在二维中,记 为旋转 角,把位置 的查询旋转 ,位置 的键旋转 。旋转满足 ,所以分数为
它只通过差 依赖位置。在 维中,各元素两两配对,每对以自己的频率旋转,与式 12.6 相同。RoPE 不增加参数,许多较新的语言模型都使用它。
6. 多头注意力
一个自注意力层为每个查询产生一组权重:一种判断哪些位置相关的方式。语言同时需要好几种:一个动词可能需要它的主语、宾语,以及句中别处表示时态的词。多头注意力并行地运行 个自注意力层,即 个头,每个头有自己大小为 的查询、键和值,然后把它们的输出组合起来:
个形状为 的输出叠成一个 矩阵,输出投影 把各头混合起来。用文字说:每个头以自己的方式关注,投影把它们的发现组合起来。把 分给各个头,使总开销与一个全尺寸的头相同。这一层有 个参数:所有头的查询、键和值合计 个,输出投影 个。 时为 2,362,368 个。GPT-2 small 使用 12 个大小为 64 的头。
7. Transformer 层
Transformer 层把在位置之间传递信息的多头自注意力,与在每个位置上分别处理信息的小型全连接网络结合起来。两者都包裹在第 11 篇的残差连接和层归一化之中(图 12.3):
第一行让每个位置从其他位置收集信息。第二行对每一列施加同一个两层网络:从 映射到 个单元,经过 GELU 激活(ReLU 的一种平滑变体 [10]),再映射回 。层归一化对每个词元的向量单独归一化(第 11 篇第 5 节),所以这一层既不依赖批,也不依赖序列长度。把它放在每个分支的开头,即前置归一化(pre-norm),能像第 11 篇的预激活残差块那样保持残差路径为严格的恒等映射;在深的堆叠中,它比原始 Transformer 在相加之后再归一化的做法训练更稳定 [9]。
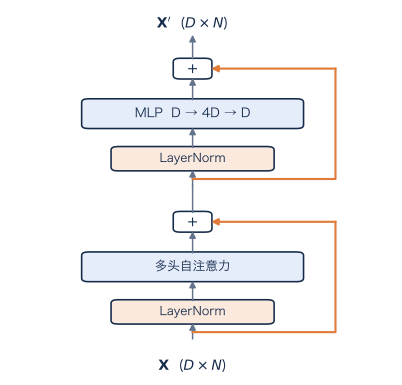
图 12.3 一个 Transformer 层(前置归一化)。 输入是一个 矩阵,每个词元一列。第一个块对每一列做归一化,在所有列之间做多头自注意力,再把结果加回去(橙色:残差连接)。第二个块对每一列做归一化,对每一列分别施加同一个两层 MLP,再把结果加回去。输出与输入形状相同,所以各层可以堆叠。
数一数真实模型
Transformer 把这样的层堆叠在输入嵌入与输出层之间。对 GPT-2 small [6],、12 层、12 个头、上下文长度 1,024 个词元,参数如下:
| 组成部分 | 参数 |
|---|---|
| 多头自注意力,每层() | 2,362,368 |
| MLP,每层() | 4,722,432 |
| 两个层归一化,每层() | 3,072 |
| 一个 Transformer 层 | 7,087,872 |
| 12 层 | 85,054,464 |
| 词元嵌入() | 38,597,376 |
| 位置嵌入() | 786,432 |
| 最后的层归一化 | 1,536 |
| 合计 | 124,439,808 |
把每个最终向量变成词表上分数的输出层复用了词元嵌入矩阵,这种常见做法称为权重绑定,所以它不增加参数。每层约有 个参数,其中三分之二在 MLP 中。在这个小模型里,嵌入几乎占了三分之一,随着 和层数增大,这个比例会下降。
每个词元的计算量也有同样的规律。矩阵乘法中的每个参数对每个词元使用一次,所以前向计算每个词元每个参数大约需要一次乘加,外加每层 的注意力项。对 的 GPT-2 small,每个词元约需 1.42 亿次乘加。
8. 编码器、解码器与掩码
Transformer 有三种用法,区别在于哪些位置可以关注哪些位置。
编码器让每个位置关注所有其他位置,如第 2–7 节所述,为每个词元输出一个在完整上下文中概括该词元的向量。BERT [5] 是标准的例子。它的训练方式是遮住文本中约 15% 的词元,再根据其余部分预测它们,这个任务称为掩码语言建模;其输出随后用于句子分类、在段落中找答案等任务。
解码器一次生成一个词元,每个位置只能关注它自己和之前的位置。这由因果掩码保证:在 softmax 之前,把每个 的分数 设为 ,于是其权重为零。在第 2 节的例子中(图 12.1c),第一个位置只能关注自己,权重为 1;第二个位置按 比 的比例把权重分给位置 1 和 2,得到 ;第三个不变。解码器被训练成在每个位置预测下一个词元:位置 的输出经过最后一层得到词表中每个词元的分数,应当给词元 高概率。损失是第 4 篇的交叉熵,在各位置上取平均。由于有掩码,位置 的输出永远看不到词元 ,所以一段文本的全部 个预测可以通过一次前向计算同时训练。GPT-2 和(截至 2026 年的)大多数大型语言模型都是解码器。
生成时,解码器计算下一个词元的分数,采样一个,把它附加到输入后面,然后重复。附加一个词元时,之前各位置的键和值不会改变,所以把它们保存起来(KV 缓存);每个新词元只需算一列查询、键和值,再对已保存的 个位置做注意力,而不必重新计算整个序列。
编码器–解码器把两者结合起来,用于把一个序列映射为另一个序列的任务,例如翻译。原始的 Transformer [2] 就是这种。解码器层中多了一个交叉注意力块,其查询来自解码器,键和值来自编码器的输出,这样每个生成的词元都能参考整个输入句子。
9. 文本之外
Transformer 层中没有任何东西专属于语言:它处理一个向量集合,位置由编码提供。视觉 Transformer [8] 把一张 的彩色图像切成 的小块,得到 196 块,每块有 个值;一个线性映射把每块变成一个词元,再由标准编码器处理这 196 个词元。由于没有卷积的局部性和权重共享(第 10 篇),它需要更多训练数据或更强的数据增强才能达到同样的准确率,但在数据充足时扩展性很好。同样的做法——把输入变成词元并加上位置——已被用于音频、蛋白质序列、视频以及它们的组合。
10. 注意力能告诉我们什么,不能告诉我们什么
注意力权重很容易可视化,人们很想把它当作解释:“模型看了这个词”。这种解读需要谨慎。每层有许多头,输出还要经过注意力权重所显示不出来的 MLP 和残差路径,而后面的层所关注的向量,本身已经混合了来自许多位置的信息。Jain 和 Wallace [11] 发现,相当不同的注意力权重可以给出同样的预测。注意力权重描述的是一层如何混合它的输入,而不是模型为什么给出它的输出。
第 3 节的平方开销是实践中的主要限制。上下文为 8,192 个词元时,每层每个头要计算约 6700 万个分数。精确注意力可以分块计算、不必存储完整的 矩阵,让每块都能放进高速内存 [14];许多近似方法还能进一步降低开销。但精确注意力的计算量仍随 增长。
小结
文本被切分成词元,每个词元映射为一个可学习的嵌入,于是每个位置得到一个向量。自注意力让每个位置计算一个查询,与每个位置的键比较,用 softmax 把分数变成权重,再对值取加权平均。这一层用同一组参数接受任意长度,对重排是等变的,所需时间和内存随长度的平方增长。把分数除以 防止 softmax 饱和,位置编码补回注意力所忽略的顺序,多个头让一层能同时以几种方式关注。Transformer 层把多头注意力和逐位置的 MLP 结合起来,二者都放在带层归一化的残差连接之中;GPT-2 small 堆叠了十二层,共 1.24 亿个参数。编码器双向关注,解码器使用因果掩码并被训练来预测下一个词元,编码器–解码器则用交叉注意力把两者连接起来。
第二部分到此结束。第 7 篇说明了深度为什么有用,第 8 篇说明了如何算出深层网络的全部梯度。第 9 篇讲解了如何防止大网络拟合噪声,第 10 篇讲解了如何把关于图像的知识构建进架构。第 11 篇让非常深的网络变得可训练,第 12 篇则把这些部件组合成了当今语言模型背后的架构。
注释
历史。 注意力由 Bahdanau、Cho 和 Bengio [3] 在 2014–15 年为机器翻译引入,用来让循环网络解码器回看编码后的源句子。Vaswani 等人 [2] 在 2017 年表明,不需要循环、只用注意力就足够了,并把结果命名为 Transformer。它的编码器–解码器基础模型两半各有 6 层,,8 个头。
规模。 Kaplan 等人 [12] 发现,在许多个数量级的范围内,随着参数、数据和计算量一起增长,语言模型的损失平滑地下降,近似服从幂律。Hoffmann 等人 [13] 发现,在固定的计算预算下,训练词元数应与参数个数成正比增长,在他们的实验中约为每个参数 20 个词元。这些是经验规律,不是自然定律,其指数取决于数据和架构。2020 年的 GPT-3 [15] 有 1750 亿个参数,96 层,;而 Transformer 层本身自 2017 年以来变化不大。
高效注意力。 应对平方开销的方法包括:只在局部窗口内关注、只关注一组固定的全局词元、用低秩近似表示注意力矩阵,以及用可以并行训练的循环结构替代注意力的架构。在中等长度上,配合精心内存管理的精确注意力 [14] 仍是最常见的选择。
延伸阅读。 Understanding Deep Learning [1] 第 12 章讲解了 Transformer,包括本文所用的矩阵表述、编码器、解码器和视觉 Transformer。
练习
练习 12.1 在第 2 节的例子中,手工计算位置 2 的输出。(答案:。)
练习 12.2 、 的单头自注意力层(含偏置)有多少个参数?序列长度加倍时这个数如何变化?(答案:;不变。)
练习 12.3 一个查询和一个键各有 128 个独立元素,均值为 0、方差为 1。缩放前后,它们点积的标准差各是多少?(答案:缩放前 ,缩放后为 1。)
练习 12.4 用 验证式 12.7。再证明把两个位置平移同样的量,分数不变。(提示:把 和 换成 和 ;差不变。)
练习 12.5 对第 2 节中第三个查询的分数 施加因果掩码。结果会变吗?为什么?(答案:不变;第三个位置可以关注位置 1–3,也就是全部位置,所以权重仍是 。)
练习 12.6 用每层参数数 ,计算 的模型中 24 个 Transformer 层共有多少个参数。(答案:,约 3.02 亿。)
练习 12.7 一个视觉 Transformer 在 的图像上使用 的小块。它处理多少个词元?与 的小块相比,注意力开销增长多少倍?(答案: 个词元;开销增长 倍。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan Gomez, Łukasz Kaiser and Illia Polosukhin (2017). Attention is all you need. Advances in Neural Information Processing Systems 30.
- 3: Dzmitry Bahdanau, Kyunghyun Cho and Yoshua Bengio (2015). Neural machine translation by jointly learning to align and translate. International Conference on Learning Representations.
- 4: Rico Sennrich, Barry Haddow and Alexandra Birch (2016). Neural machine translation of rare words with subword units. Annual Meeting of the Association for Computational Linguistics.
- 5: Jacob Devlin, Ming-Wei Chang, Kenton Lee and Kristina Toutanova (2019). BERT: pre-training of deep bidirectional transformers for language understanding. Conference of the North American Chapter of the Association for Computational Linguistics.
- 6: Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei and Ilya Sutskever (2019). Language models are unsupervised multitask learners. OpenAI technical report.
- 7: Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo and Yunfeng Liu (2024). RoFormer: enhanced transformer with rotary position embedding. Neurocomputing 568.
- 8: Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, Matthias Minderer, Georg Heigold, Sylvain Gelly, Jakob Uszkoreit and Neil Houlsby (2021). An image is worth 16x16 words: transformers for image recognition at scale. International Conference on Learning Representations.
- 9: Ruibin Xiong, Yunchang Yang, Di He, Kai Zheng, Shuxin Zheng, Chen Xing, Huishuai Zhang, Yanyan Lan, Liwei Wang and Tie-Yan Liu (2020). On layer normalization in the transformer architecture. International Conference on Machine Learning.
- 10: Dan Hendrycks and Kevin Gimpel (2016). Gaussian error linear units (GELUs). arXiv:1606.08415.
- 11: Sarthak Jain and Byron Wallace (2019). Attention is not explanation. Conference of the North American Chapter of the Association for Computational Linguistics.
- 12: Jared Kaplan, Sam McCandlish, Tom Henighan, Tom Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu and Dario Amodei (2020). Scaling laws for neural language models. arXiv:2001.08361.
- 13: Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch and colleagues (2022). Training compute-optimal large language models. Advances in Neural Information Processing Systems 35.
- 14: Tri Dao, Daniel Fu, Stefano Ermon, Atri Rudra and Christopher Ré (2022). FlashAttention: fast and memory-efficient exact attention with IO-awareness. Advances in Neural Information Processing Systems 35.
- 15: Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah and colleagues (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems 33.