损失函数:衡量模型错得有多厉害
把预测变成一个数:均方误差、softmax 与交叉熵。
第 1 篇和第 3 篇把模型描述为一族函数:每选一组参数,就得到一条不同的直线或一个不同的网络。要从数据中学习,我们必须说明哪一组参数更好,而且“更好”必须是计算机能比较的数。损失函数提供的正是这个数:它根据模型在训练数据上的预测,返回一个值,预测好时这个值小,预测差时这个值大。本文先构造预测数值时用的损失,把它画成参数上的一张地图,再构造预测类别时用的损失。
1. 衡量直线离数据有多远
我们回到第 1 篇的房价。图 4.1 给出了三条候选直线:第一条每年都预测同一个价格 1.45;第二条上升得太陡;第三条紧贴着数据。我们一眼就能看出哪条最好,但需要一条计算机能执行的规则。
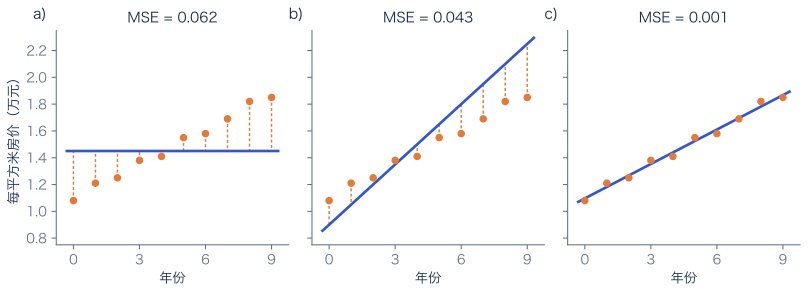
图 4.1 三条直线及其误差。 每幅图都画出房价数据(橙色)和一条直线 (蓝色)。虚线段是误差,即每个数据点与直线之间的竖直距离。a),:一条水平线,均方误差 0.0622。b),:太陡,0.0434。c),:最好的直线,0.00063。
这条规则从每个样本的误差出发:预测值 与真实值 之差,也就是图 4.1 中的虚线段。为了把十个误差合成一个数,我们把每个误差平方,再取平均:
这个计算可以分成三步。首先,对每个训练样本 ,算出预测值并减去真实值。其次,把结果平方。最后,把全部 个样本的平方加起来,再除以 。这就是均方误差(MSE)。用文字说:均方误差是预测值与真实值之间距离平方的平均。
图 4.1a 的水平线每年都预测 1.45。第 0 年的真实价格是 1.08,误差为 ,平方为 ;第 9 年的真实价格是 1.85,误差为 ,平方为 。十个平方加起来是 ,除以 ,得到 。同样的计算,太陡的直线得到 ,紧贴数据的直线得到 。
平方有两个作用。一是让每个误差都按正数计入,直线上方和下方的误差不会相互抵消。二是让大误差比小误差重要得多:误差 0.4 对损失的贡献是误差 0.1 的 16 倍。有时这并不理想,比如少数数据点本身记录有误时。平均绝对误差改为对 取平均,受这类点的影响较小。
2. 损失地图
损失取决于参数。我们的直线只有两个参数 和 ,因此可以对每一种组合计算损失,画成一张地图(图 4.2)。地图上的每个点代表一条直线,颜色表示这条直线的损失。
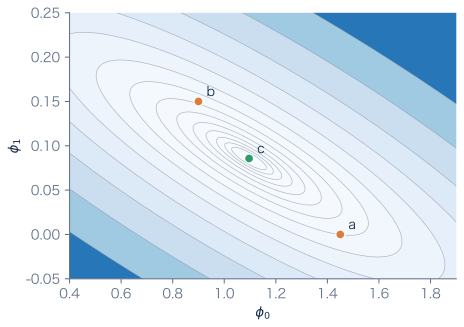
图 4.2 房价直线的损失地图。 每个点 都是一条直线,颜色表示这条直线在十个数据点上的均方误差,蓝色越深损失越大。灰色曲线连接损失相等的直线。点 a 和 b(橙色)是图 4.1a 和 4.1b 中的直线,点 c(绿色)是图 4.1c 中的直线,位于地图的最低点。
训练模型,就是寻找这张地图上的最低点。对一条直线,我们可以直接看到它,就是绿色的点 c。地图还显示了一个不那么显然的现象:低损失区域是一条沿对角线延伸的狭长山谷。提高斜率 的同时降低截距 ,直线仍然从数据中部附近经过,所以许多这样的参数组合损失相近。第 5 篇会说明,山谷的形状会影响训练找到谷底的速度。
一个有数百万个参数的网络,它的损失地图有数百万个维度,谁也画不出来。但原理不变:损失给每一组参数分配一个数,训练就是寻找这个数较小的参数。这种图景通常称为损失曲面或损失地形。
3. 预测类别
对分类任务,输出是“猫”“狗”“其他”这样的类别,类别之间的差的平方没有意义。我们改为让网络对每个类别输出一个数,再把这些数转换成概率。
假设网络看了一张照片后,输出的分数是:猫 ,狗 ,其他 。分数可以是任意的数,正负都可以。softmax 函数把它们转换成概率:
其中 是类别数, 是指数函数。这个计算可以分成两步。首先,取指数使每个分数都变为正数,且保持大小顺序:,,。其次,除以它们的和 ,使它们加起来等于 1。得到的概率是 、、(图 4.3a–b)。用文字说:softmax 把分数变成概率,分数越高,概率一定越高。
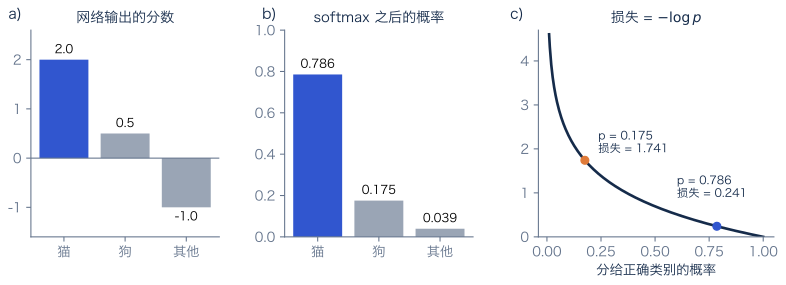
图 4.3 从分数到分类损失。 a)网络对三个类别给出的分数。b)softmax(式 4.2)把它们变成加起来等于 1 的概率。c)交叉熵损失 ,其中 是分给正确类别的概率。如果照片里是猫,,损失为 0.241(蓝);如果是狗,,损失为 1.741(橙)。
4. 交叉熵损失
好的分类器应当给正确类别很高的概率。交叉熵损失用对数来衡量这一点:
其中 是模型分给正确类别 的概率, 是自然对数。在整个训练集上,我们对所有样本的这个量取平均,正如均方误差对样本取平均一样。
图 4.3c 展示了这个损失的性质。如果照片里确实是猫,损失为 ;如果是狗,模型只给了正确答案 0.175 的概率,损失为 ;如果两者都不是,损失为 。正确类别的概率趋近 1 时,损失趋近 0;概率趋近 0 时,损失无限增大。因此,一个很自信却答错的模型,受到的惩罚远大于一个拿不准的模型。
只有两个类别时,比如垃圾邮件和正常邮件,网络常常只输出一个分数 ,再用 sigmoid 函数 把它转换成第一类的概率。对第一类的样本,损失为 ;对另一类的样本,损失为 。这称为二元交叉熵,是式 4.3 在两个类别时的特例。
5. 如何选择损失
损失由输出的类型决定:
| 任务 | 输出 | 常用损失 |
|---|---|---|
| 回归(价格、气温) | 一个数 | 均方误差,或平均绝对误差 |
| 二分类(是否垃圾邮件) | 一个概率 | 二元交叉熵 |
| 多分类(猫、狗、其他) | 每个类别一个概率 | softmax 之后的交叉熵 |
| 目标检测 | 框和类别 | 框的误差(如坐标的绝对误差)加上类别的交叉熵 |
| 分割 | 每个像素一个类别 | 每个像素的交叉熵,对所有像素取平均 |
损失用于训练,所以参数稍有变化时,它也必须平滑地变化,原因在第 5 篇解释。这就是为什么训练分类器用交叉熵,而不用答对的百分比:答对的百分比会从一个值跳到另一个值,无法提示参数该往哪个方向调整。不过在报告模型好坏时,我们仍然使用百分比之类的评估指标,第 6 篇会介绍它们。
小结
损失函数把模型在训练数据上的预测变成一个数,衡量预测错得有多厉害。预测数值时,均方误差对预测值与真实值之差的平方取平均。损失取决于参数,因此可以画成一张地图,训练就是寻找地图的最低点。预测类别时,softmax 把网络的分数变成概率,交叉熵损失是分给正确类别的概率取对数后的相反数。
注释
为什么用这些损失。 均方误差和交叉熵都可以从同一个原理推出,即最大似然:选择使观测到的训练数据出现概率最大的参数。假设误差服从正态(高斯)分布,就得到均方误差;把输出看作每个类别的概率,就得到交叉熵。《Understanding Deep Learning》[1] 第 5 章详细推导了这一方法,并用它构造其他类型输出的损失。
求和还是平均。 有些书把平方误差损失定义为对样本求和,而不是求平均。两者只相差一个常数因子 ,所以最低点相同。
分数与概率。 softmax 之前的分数常称为 logits。给每个分数加上同一个常数,概率不变,所以真正起作用的只是分数之间的差。
练习
练习 4.1 一条直线对三年的预测分别是 1.50、1.60 和 1.70,这三年的真实价格是 1.40、1.65 和 1.70。它的均方误差是多少?(答案:。)
练习 4.2 一个网络对三个类别输出的分数是 。softmax 给出的概率是多少?无论哪个类别正确,交叉熵损失是多少?(答案:每个概率都是 ,损失为 。)
练习 4.3 解释为什么式 4.3 中的损失不可能是负数。
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.