神经网络:能够拐弯的函数
手工搭建一个小网络,看 ReLU 单元如何让函数拐弯。
第 1 篇的直线有两个参数,却只有一种形状:它只能描述以恒定速度变化的关系。第 2 篇指出了传统方法的另一个局限:特征必须由人来设计。本文介绍神经网络,这一族函数几乎可以弯成任何形状,而且可以很自然地从一个输入扩展到数百万个输入。我们先手工搭建一个最小的、有意义的网络,看看它能表示什么,然后再推广。
1. 有三个隐藏单元的网络
我们从一个把单个输入 映射为单个输出 的网络开始,就像房价直线那样。一般的定义留到第 3 节。这个网络先计算三个中间值 、、,再把它们组合起来:
这个计算可以分成三步。首先,计算输入的三个不同的线性函数 等,每个都有自己的偏移和斜率。其次,把每个结果送入函数 。最后,把三个结果分别乘以 、、,相加,再加上偏移 。这个网络共有十个参数:六个 (读作“theta”)和四个 。
要把描述补充完整,还需要定义 ,它称为激活函数。最常用的选择是修正线性单元,即 ReLU:
用文字说:ReLU 让正数原样通过,把负数变成零。
为了看网络怎样工作,我们给十个参数取值:
| 偏移 | 斜率 | 输出权重 | |
|---|---|---|---|
| 单元 1 | |||
| 单元 2 | |||
| 单元 3 |
输出偏移为 。对输入 ,三个线性函数分别给出 、 和 。ReLU 保留第一个,把后两个变为零,所以 ,。输出为:
图 3.1 对 0 到 2 之间的每个输入重复了这一计算。
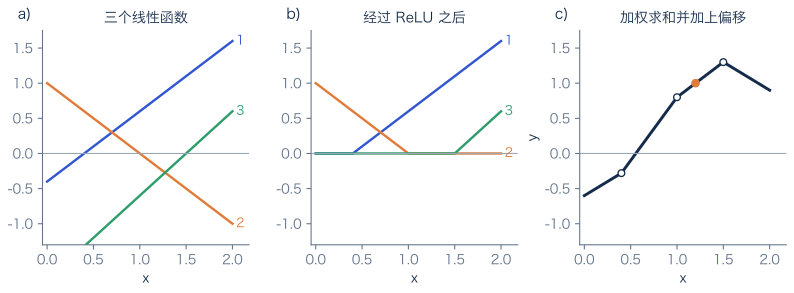
图 3.1 网络如何构造输出。 a) 时的三个线性函数 (蓝、橙、绿)。b)经过 ReLU 后,每条线在原本为负的地方都变成零。c)式 3.2 的输出 是(b)中三条曲线的加权和再加上 。它由几段直线组成,在 、、 三处拐弯(空心圆)。橙色点是算例 ,。
2. 网络能表示什么
图 3.1c 展示了关键的性质:输出仍由直线段组成,但和单条直线不同,它可以改变方向。每个隐藏单元贡献一个拐点,位于它的线性函数穿过零、ReLU 在“关”和“开”之间切换的地方。对单元 ,这发生在 ,即 处。按我们的取值,拐点位于 、 和 。
在两个拐点之间,每个单元要么关闭(什么也不贡献),要么开启(贡献一条直线),所以输出在这一段上也是直线,斜率等于开启的各单元斜率之和。当 时,单元 1 和 2 开启,斜率为 。过了 ,单元 1 和 3 开启,斜率为 ,于是输出转而向下。改变一个单元的偏移,会让它的拐点左右移动;改变它的输出权重,会改变输出在那里弯折的程度。
像这样由直线段组成的函数称为分段线性函数。只有一个输入、三个隐藏单元时,网络最多有三个拐点,因此最多分成四段。隐藏单元越多,拐点就可以越多。图 3.2 展示了 3、6、12 个隐藏单元的网络逼近一条光滑曲线的情形,网络与曲线之间的最大差距从 0.89 缩小到 0.25,再到 0.07。
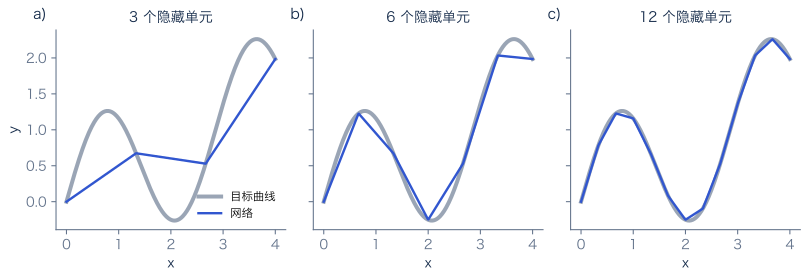
图 3.2 隐藏单元越多,越灵活。 a–c)分别有 3、6、12 个隐藏单元的网络(蓝)在 到 之间逼近一条光滑的目标曲线(灰)。这里的参数是人工选定的,让网络的拐点等间距地落在曲线上。单元越多,直线段越短,逼近得越好。
这个规律具有普遍性。万能逼近定理[2]、[3] 指出:只要隐藏单元足够多,只有一个隐藏层的网络就能在有界的输入范围内,以任意精度逼近任何连续函数。这个定理讲的是网络能够表示什么。它没有说需要多少个隐藏单元,没有说训练一定能找到好的参数(第 5 篇),也没有说结果在新数据上一定表现良好(第 6 篇)。
3. 多个输入和多个输出
实际问题往往有不止一个输入。房价模型可能会同时用年份、面积和到市中心的距离。推广的方式很直接:每个隐藏单元先对所有输入求加权和,再送入激活函数。若输入为 ,隐藏单元 计算:
如果有多个输出,每个输出 都有自己的一组权重来组合隐藏单元:
这里 是输入的个数, 是隐藏单元的个数, 是输出的个数。当只有一个输入、三个隐藏单元、一个输出时,式 3.4 和 3.5 就退化为式 3.1 和 3.2。
数一数参数是很有用的检查。每个隐藏单元有一个偏移和 个输入权重,每个输出有一个偏移和 个权重,总数为:
我们的第一个网络有 个参数,与前面数的一致。一个有 3 个输入、4 个隐藏单元、1 个输出的房价网络有 个参数。若把猫照片的 135,300 个像素输入 100 个隐藏单元、得到 3 个输出,就需要 13,530,403 个参数,这也是图像要用第 2 篇提到的卷积网络的原因之一。
用向量和矩阵来写,式 3.4 和 3.5 就是 和 ,其中 逐个作用于每个元素。这是同一个计算的紧凑写法,记号页解释了其中的符号。
4. 深层网络
到目前为止的网络只有一个隐藏层:输入和输出之间的一组隐藏单元。深层网络有多个隐藏层,每一层把上一层的输出当作自己的输入(图 3.3)。第二层对 计算新的线性函数,再次送入激活函数,依此类推。
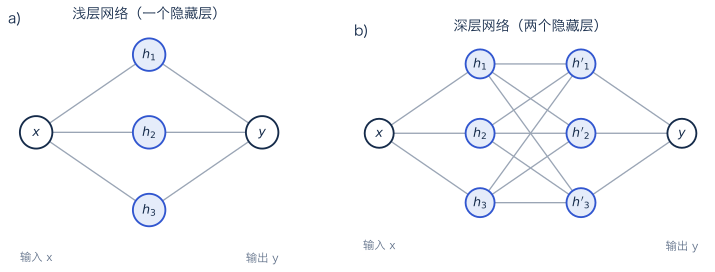
图 3.3 浅层网络与深层网络。 a)第 1 节的网络:一个输入、一个有三个单元的隐藏层、一个输出。每条连线对应一个权重。b)有两个隐藏层的深层网络。第二层()以第一层的输出作为输入。
使用 ReLU 激活时,深层网络仍然是分段线性的,但层层堆叠能以经济得多的方式产生拐点。第二层可以把第一层造出的线段折叠、组合起来,因此线性段的数量随深度增长的速度可以远远快于随宽度增长的速度 [4]。对实践中遇到的许多函数,深层网络用比浅层网络更少的参数就能达到同样的精度,而且通常也更容易训练好。这就是现代网络几乎都是深层网络的原因。
5. 激活函数为什么重要
没有激活函数,深度就毫无用处。假设两层都是纯线性的:,然后 。把第一个式子代入第二个,得到:
这两层与一条直线完全等价。无论有多少个线性层、每层有多少个单元,结论都一样:把一层代入下一层,得到的永远还是线性函数。没有激活函数的深层网络,所能表示的不会超过单个线性层。
在层与层之间加入 ReLU,就打破了这种代入。函数 在 时等于 ,在 更大时等于 :它有一个拐角,没有哪条直线能描述它。激活函数让网络能够弯折,而弯折层层叠加,正是深度发挥作用的方式。
在二维平面上更容易看到这个效果。下面的实验里,一个有三个 ReLU 隐藏单元的网络(和第 1 节一样,只是有两个输入)要学会把中间的一簇点和外面的一圈点分开。
点击播放。每个隐藏单元计算一个只有一道直折痕的斜坡,把鼠标悬停在单元上就能看到。大约一百轮之内,三道折痕会组合成一个有棱角的封闭区域,围住中间的点。 然后把 Activation 改成 Linear。网络会重置,再训练一次。无论训练多久,边界都只是一条直线,损失也不再下降,因为线性单元相加仍然只是一个线性函数。
6. 术语
看清了网络的计算过程之后,我们再给各部分命名。
- 输入层存放输入 ,输出层产生 ,二者之间的层称为隐藏层,因为它们的值在训练数据中从来观测不到。
- 中间值 称为隐藏单元,也叫神经元。激活函数之前的值,如 ,称为预激活;激活函数之后的值称为激活值。
- 斜率(、 等)称为权重,偏移(、 等)称为偏置。
- 一层中隐藏单元的个数是这一层的宽度,隐藏层的个数是网络的深度。
- 若每一层的每个单元都与下一层的每个单元相连,网络就是全连接的。本文的网络都属于这一类,也称为多层感知机。
小结
神经网络先计算输入的线性函数,再送入 ReLU 等激活函数,最后把结果线性组合。使用 ReLU 时,每个隐藏单元增加一个拐点,因此网络描述的是分段线性函数;隐藏单元足够多时,它可以逼近任何连续函数。这一思路可以直接推广到多个输入、多个输出和多个层。没有激活函数,任意多层的堆叠都会退化为一个线性函数。现在我们有了一族灵活的函数;第 4 篇将定义怎样衡量其中哪个成员最符合数据。
注释
其他激活函数。 早期的网络使用 sigmoid 函数 和 。ReLU [5] 成为默认选择,是因为它计算简单,而且输入为较大的正数时斜率不会趋近于零,这让深层网络更容易训练。GELU 等较新的变体在零附近是光滑的;使用它们时,网络不再严格分段线性,但本文的图景仍然能很好地描述它。
函数相同,训练不同。 两个堆叠的线性层与一个线性层能表示的函数相同,但在训练时并不完全一样:在梯度下降中,两个权重矩阵的乘积与单个矩阵的变化方式不同。这在研究网络如何学习时很重要,但它不会增加新的可表示函数。
“神经元”。 这个名字来自与神经细胞的粗略类比:神经细胞接收许多输入,受到足够的刺激时就会放电。现代网络并不是大脑的模型,这个类比也解释不了网络为什么有效。
延伸阅读。 《Understanding Deep Learning》[1] 第 3、4 章更深入地讨论了浅层和深层网络,包括如何计算线性区域的数目。
练习
练习 3.1 用第 1 节的参数取值,计算 和 时的 。(答案: 和 。)
练习 3.2 一个全连接网络有 10 个输入、一个 20 个单元的隐藏层和 2 个输出,它有多少个参数?(答案:。)
练习 3.3 一个网络有三个线性层而没有激活函数:,,。把 写成 的一个线性函数。(答案:。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Kurt Hornik, Maxwell Stinchcombe and Halbert White (1989). Multilayer feedforward networks are universal approximators. Neural Networks 2(5), 359–366.
- 3: Moshe Leshno, Vladimir Lin, Allan Pinkus and Shimon Schocken (1993). Multilayer feedforward networks with a nonpolynomial activation function can approximate any function. Neural Networks 6(6), 861–867.
- 4: Guido Montúfar, Razvan Pascanu, Kyunghyun Cho and Yoshua Bengio (2014). On the number of linear regions of deep neural networks. Advances in Neural Information Processing Systems 27.
- 5: Vinod Nair and Geoffrey Hinton (2010). Rectified linear units improve restricted Boltzmann machines. International Conference on Machine Learning.