特征:把原始数据变成有用的数字
原始数据如何变成有用的数字:从词频统计到边缘滤波。
第 1 篇讲到,传统机器学习依赖人工设计的特征。本文说明什么是特征,并一步一步地算出几种经典的图像特征,细到每一次乘法。看清这些特征需要多少人工设计,也就明白了深度学习替我们省掉了哪些设计。
1. 什么是特征
特征是从原始数据计算出来的数,它用另一种形式表达数据,让任务更容易完成。原始数据是我们直接记录下来的东西:每一笔房屋交易、照片的每一个像素、消息中的每一个词。特征则对它们进行概括或变换。
第 1 篇中的房价本身就是一个特征。原始数据应当是成千上万笔单独的交易,每笔都有成交价、面积和日期。我们把每一年压缩成一个数,即每平方米的平均价格。同一份数据还可以算出其他有用的特征,例如价格的方差,衡量价格的分散程度;又如每年的成交笔数,衡量市场的活跃程度。
文本是另一个例子。假设我们要区分垃圾邮件和正常邮件,一个简单的特征是统计几个选定的词各出现了几次:
| 消息 | “free” | “winner” | “prize” | “meeting” | “notes” |
|---|---|---|---|---|---|
| “Congratulations, you are a winner! Claim your free prize now.” | 1 | 1 | 1 | 0 | 0 |
| “Can we move the meeting to Friday? I will send the notes.” | 0 | 0 | 0 | 1 | 1 |
每条消息都变成了一串五个数,称为特征向量。学习算法看不到原句,只能看到这些向量,因此它只能学到向量中保留下来的信息。如果发垃圾邮件的人把“free”写成“fr3e”,这个特征就会漏掉它。选择特征,就是事先决定允许模型使用哪些信息。
2. 图像是数字组成的网格
灰度图像是一个数字网格,每个像素一个数,通常从 0(黑)到 255(白)。图 2.1 放大了第 1 篇那张猫的照片中的一块 区域,位置在明亮的毛发与深色眼眶的交界处。数值从左边的 150 左右降到右边的不足 30。彩色图像则存储三张这样的网格,分别对应红、绿、蓝。
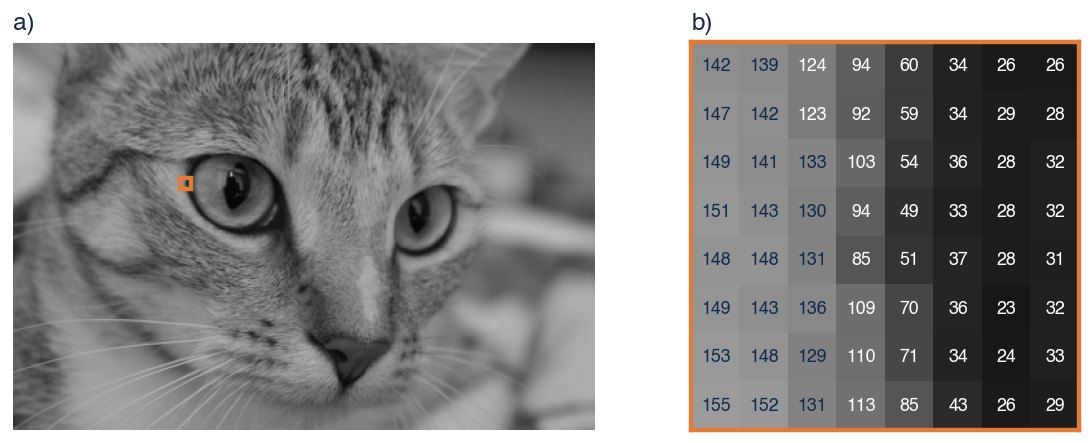
图 2.1 图像是数字组成的网格。 a)灰度的猫照片( 个像素)。橙色方框标出左眼边缘的一块 区域。b)放大后的这块区域,每个像素的数值从 0(黑)到 255(白)。在毛发与眼眶交界处,亮度从左到右急剧下降。
人看一眼图 2.1a 就知道是猫,计算机收到的却是 135,300 个数。图像特征试图从这些数中算出与图像内容关系更直接的量,比如边缘在哪里。
3. 用小卷积核做滤波
许多经典图像特征都来自同一种运算:把一个小的权重网格(称为卷积核)在图像上滑动,在每个位置计算它覆盖的像素的加权和。我们先看一个位置和一个 的卷积核,之后再推广到整幅图像。
取图 2.1b 中第 3–5 行、第 3–5 列的 窗口:
再取一个同样大小的卷积核 。滤波器在这个位置的输出是:
符号 表示“求和”。式 2.1 的意思是:把每个像素乘以卷积核在同一位置的权重,再把九个乘积加起来。卷积核决定了输出衡量的是什么。我们试两个卷积核。
平均卷积核。 如果每个权重都是 ,输出就是九个像素的平均值:
取平均会抹平相邻像素之间的差别。
边缘卷积核。 检测左右方向变化的 Sobel 卷积核是:
它用右列减去左列,中间一行计两次。对我们的窗口,左列贡献 ,右列贡献 ,中间一列不贡献,所以:
这个很大的负值说明亮度从左到右急剧下降,正如眼眶边缘的情形。作为对比,第 1–3 行、第 6–8 列的窗口位于深色区域内部,像素彼此接近,同一个卷积核在那里只给出 。输出的大小衡量边缘的强弱,符号则说明哪一侧更亮。
把卷积核滑到图像的每个位置,把每个输出写在对应位置,就得到一幅新图像,有时称为特征图。这种滑动的加权求和称为卷积。严格地说,式 2.1 是互相关:数学上的卷积要先把卷积核翻转。深度学习库用的也是不翻转的版本,但仍然称之为卷积。
4. 经典滤波器一览
图 2.2 把几种经典滤波器作用于整张照片。每种滤波器都保留一部分信息,丢掉其余的信息。
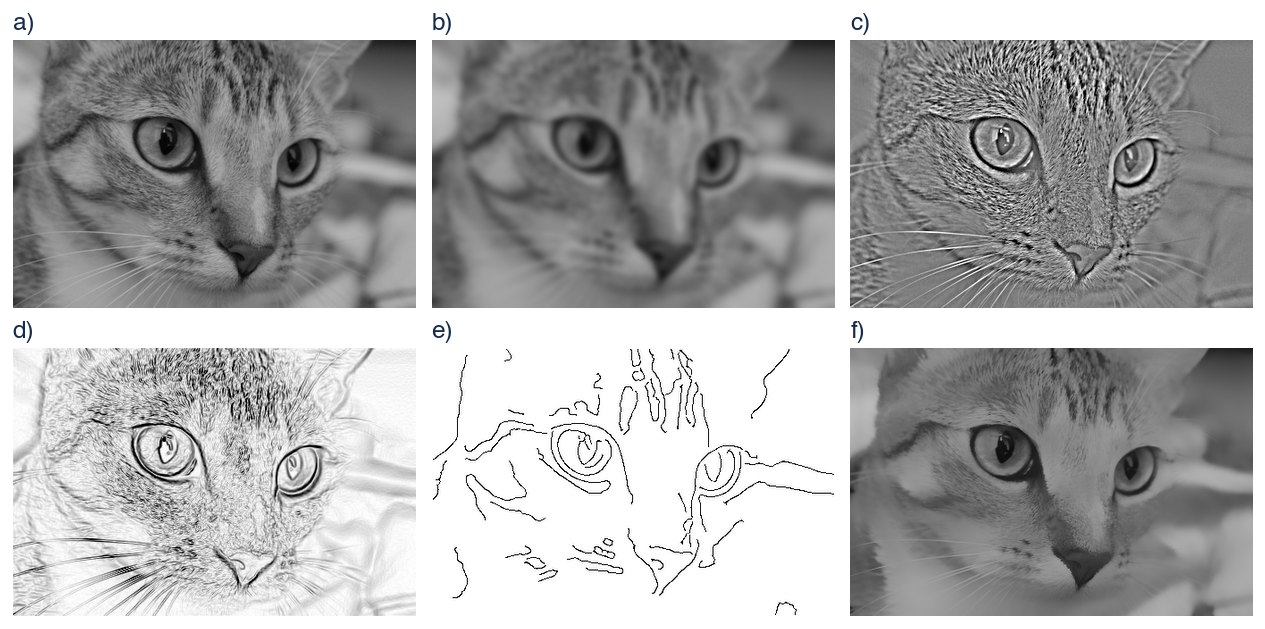
图 2.2 经典图像滤波器。 a)原始灰度图像。b)低通:宽度为 3 个像素的高斯模糊,保留亮度的缓慢变化,去掉细节。c)高通:用(a)减去(b),只剩下毛发、胡须等细节。d)由 Sobel 卷积核得到的边缘强度,颜色越深表示边缘越强。e)Canny 边缘:细而连续的边缘曲线。f)双边滤波:毛发被平滑,眼睛和鼻子的边缘仍然清晰。
- 低通滤波(图 2.2b)把每个像素与邻近像素取平均,和我们的平均卷积核一样。高斯模糊给近处像素的权重比远处大。结果保留了大的形状,去掉了细节和噪声。
- 高通滤波(图 2.2c)作用相反。一种做法是用原图减去低通图像,剩下的正是模糊去掉的部分:纹理、胡须、噪声。
- 梯度滤波(图 2.2d)用 Sobel 卷积核分别计算左右方向和上下方向的变化,再把两者合成为每个像素的边缘强度。
- Canny 边缘检测器[2](图 2.2e)是一个多步骤的过程,而不是单个卷积核。它先模糊图像,再计算梯度,然后只保留在垂直于边缘的方向上边缘强度达到峰值的像素,最后用两个阈值把它们连接起来,输出一组干净的边缘曲线。
- 双边滤波[3](图 2.2f)把每个像素与那些既靠近、亮度又相近的邻居取平均。跨过边缘时,邻居的亮度差别很大,权重很小,所以边缘保持清晰,平坦区域则被平滑。由于权重取决于图像本身,它不是用固定卷积核做的卷积。
每一幅图都取决于我们做出的选择:模糊的宽度、Canny 的阈值、双边滤波中两个像素要多接近才算“相似”。选择不同,结果也明显不同。
5. 从滤波结果到答案
滤波的输出仍然是图像,数据量仍然很大。传统流程会进一步把它们概括为紧凑的描述子。著名的例子是方向梯度直方图(HOG)[4]:把图像分成小格,在每个小格中统计朝各个方向的边缘强度各有多少。另一个例子是 SIFT [5],它描述图像中显著点周围的局部区域,以便在不同图像之间匹配这些点。然后由分类器,比如第 1 篇提到的支持向量机,学习从描述子到类别的映射。
这些系统确实有效。例如,HOG 加支持向量机曾是检测行人的标准方法。但每一个环节都由人设计,设计者必须猜测最终任务需要哪些信息。
6. 人工特征的局限
人工设计的特征有三个弱点。第一,它们必须针对每类数据、往往还要针对每个任务分别发明;照片的边缘特征对声音和文本毫无用处。第二,每种特征都会丢掉信息,而丢掉的信息之后无法找回。图 2.2e 的 Canny 结果已经丢掉了毛发的纹理,而这可能正是区分虎斑猫和老虎的关键。第三,它们的参数靠手工调节,适合一个数据集的设置,换一个数据集可能就不合适了。
卷积神经网络[6] 保留了第 3 节的滑动加权求和,但卷积核的权重以及之后的所有环节都从训练数据中学习。用这样的网络对照片分类,训练后第一层的卷积核往往很像边缘检测器和颜色检测器 [7],与人们设计的滤波器相似;更深层的卷积核则对越来越复杂、没有人指定过的模式产生响应。第 3 篇介绍让这一切成为可能的神经网络,卷积网络则留到课程的下一部分。
人工选择特征和让模型学习特征有什么不同,在一个小问题上很容易试出来。下面的实验里,一个没有隐藏单元、只对输入做加权求和的模型,要把中间的一簇点和外面的一圈点分开。
点击播放。模型只能对 X₁ 和 X₂ 加权求和,所以边界是一条直线,损失停在 0.5 左右不再下降:没有哪条直线能把圆盘和外面的圆环分开。 然后点击 X₁² 和 X₂²,把它们也作为输入。模型会重置,再训练一次。大约二十轮之内,边界变成一个圆,损失降到 0.02 以下,因为 X₁² + X₂² 正是到中心距离的平方。选出这两个特征,需要事先知道数据是圆形的。第 3 篇会展示有隐藏单元的网络如何自己找到这样的形状。
小结
特征是从原始数据计算出来、让任务更容易完成的数。图像是数字组成的网格,许多经典图像特征来自把小卷积核在图像上滑动并计算加权和:平均卷积核起平滑作用,Sobel 卷积核对边缘产生响应。Canny 边缘、双边滤波以及 HOG 这样的描述子都建立在这些运算之上。它们都需要人做选择,并且都会丢掉信息。深度学习保留了滑动卷积核的计算方式,但卷积核本身从数据中学习。
注释
卷积与频率。 “低通”“高通”这两个词来自信号处理。亮度的平缓变化对应低空间频率,细节对应高空间频率;模糊去掉的是高频成分。
图像边界。 在图像边缘,卷积核有一部分落在图像外面。常见的处理方法有三种:在图像外补零;重复边界像素;或者只在卷积核完全落在图像内的位置计算输出,这样输出会略小一些。
文本特征。 词频统计称为词袋,因为它不考虑词的顺序。一种常用的改进是 TF-IDF,它降低几乎每篇文档都会出现的词的权重。现代语言模型则自己学习词的表示。
延伸阅读。 《Understanding Deep Learning》[1] 第 10 章讲解卷积网络,包括学习得到的卷积核如何逐层堆叠。
练习
练习 2.1 把平均卷积核和 Sobel 卷积核 作用于图 2.1b 中第 1–3 行、第 1–3 列的窗口。(答案:平均值为 ,Sobel 输出为 。)
练习 2.2 写出一个对上下方向的亮度变化(而不是左右方向)产生响应的 卷积核。(提示:把 旋转 90 度。)
练习 2.3 一张白底上画着黑色方块的照片,分别经过双边滤波和高斯模糊。描述两种情况下方块的边缘各是什么样子。
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: John Canny (1986). A computational approach to edge detection. IEEE Transactions on Pattern Analysis and Machine Intelligence 8(6), 679–698.
- 3: Carlo Tomasi and Roberto Manduchi (1998). Bilateral filtering for gray and color images. International Conference on Computer Vision.
- 4: Navneet Dalal and Bill Triggs (2005). Histograms of oriented gradients for human detection. Conference on Computer Vision and Pattern Recognition.
- 5: David G. Lowe (2004). Distinctive image features from scale-invariant keypoints. International Journal of Computer Vision 60, 91–110.
- 6: Yann LeCun, Léon Bottou, Yoshua Bengio and Patrick Haffner (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE 86(11), 2278–2324.
- 7: Alex Krizhevsky, Ilya Sutskever and Geoffrey Hinton (2012). ImageNet classification with deep convolutional neural networks. Advances in Neural Information Processing Systems 25.