机器学习:从例子中学习一个函数
什么是模型,以及从例子中学习函数与手写函数有何不同。
机器学习中的大多数问题,归根结底都在求同一样东西:一个函数,输入某些数据,输出正确的结果。本文先用一个小例子把这件事讲具体,再说明从例子中“学习”一个函数和手工写出一个函数有什么不同,以及深度学习比早期方法多走了哪一步。后面几篇依次介绍各个组成部分:特征、神经网络、损失函数、训练和评估。
阅读本课程只需要中学代数和函数的概念。第 5 篇会用到导数,用到时会给出必要的解释。课程的结构参照 Simon Prince 的《Understanding Deep Learning》[1]。这本书可以免费在线阅读,学完本课程后可以接着读它。
1. 输入、输出与模型
许多看起来不同的任务,形式其实一样:给定一个输入,要求得到一个输出。下面四个例子展示了它们的范围:
| 任务 | 输入 | 输出 |
|---|---|---|
| 预测房价 | 年份 | 当年每平方米的平均房价 |
| 图像分类 | 一张照片 | 一个类别,例如“猫”“狗”或“其他” |
| 目标检测 | 一张照片 | 每个物体外面的一个框,以及它的类别 |
| 分割 | 一张照片 | 每个像素的类别 |
图 1.1 在同一张照片上展示了三种图像任务,从左到右越来越难。分类只需对整张图给出一个答案;检测还要指出物体在“哪里”;分割则要对这张图的 135,300 个像素逐一判断它是否属于猫。
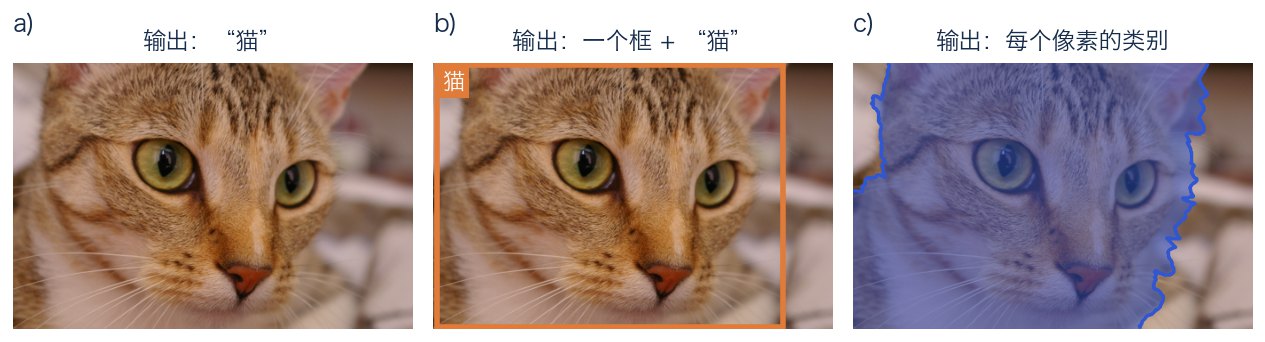
图 1.1 同一张图像上的三种任务。 a)分类:输出是整张图像的一个类别。b)目标检测:输出是框住物体的一个框,以及类别。c)分割:输出是每个像素的类别,这里涂色的像素属于“猫”,其余属于“背景”。图中是每个任务要求的输出,由人工标出,并非训练好的模型给出的预测。照片:scikit-image 示例图像“chelsea”(CC0)。
在所有这些任务中,我们都想要一个函数 ,把输入 映射为输出 :
我们把 称为模型。对新的输入 计算出 ,称为推理或预测。本文接下来讨论 从哪里来。
2. 第一个模型:一条直线
考虑一座虚构城市的平均房价。我们有十年的数据,每年一个数值(图 1.2):每平方米的价格从 1.08 万元涨到了 1.85 万元。我们想预测第 10 年,也就是最后一次测量之后那一年的房价。
最简单的合理模型是一条直线:
其中 是年份, 是预测的房价。 和 (读作“phi 零”和“phi 一”)这两个数是模型的参数,合起来记为 。 是直线在第 0 年的高度, 是直线的斜率,即每过一年房价变化多少。
式 1.2 描述的不是一条直线,而是一整族直线:每选一组 和 ,就得到其中一条。选定参数,就是从这一族中挑出一个成员。对这组数据,、 的直线从每个数据点附近经过(图 1.2)。它对第 10 年的预测是:
也就是每平方米约 1.95 万元。
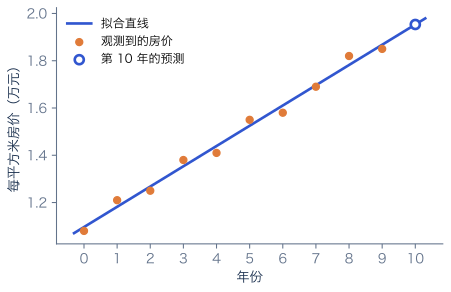
图 1.2 房价的直线模型。 橙色的点是一座虚构城市第 0 到第 9 年每平方米的平均房价。蓝线是 、 时的式 1.2。把直线延长到第 10 年,得到预测值 1.953(空心圆)。
这两个数是怎么找到的,我们暂时不讲,留给第 4、5 篇。不过现在就有两点需要注意。第一,这个预测假设过去十年的趋势会延续下去,而数据本身并不能保证这一点。第二,直线不会拐弯,如果房价加速上涨或者趋于平稳,这一族函数都无法跟上。第 3 篇会介绍能够拐弯的模型。
3. 用学习代替手写规则
构造 的一种办法是手工写出来:由专家研究市场,写下一个公式。机器学习走的是另一条路:我们选定一族函数,例如所有的直线,再让算法根据一组例子,从这一族中挑出与例子最吻合的那个成员。这些例子称为训练数据,根据它们选择参数的过程称为训练或学习。
如果每个训练样本都附带正确的输出,比如我们的房价数据,这类任务就称为监督学习。在深度学习普及之前,人们已经发展出许多这样的算法。它们的区别在于搜索哪一族函数,以及怎样搜索:
- 线性回归拟合一条直线;有多个输入时,拟合一个平面。图 1.2 就是一个例子。
- 支持向量机[2] 用一条边界把两个类别分开,并让边界两侧留出尽可能宽的间隔。
- 随机森林[3] 构建许多棵决策树,每棵树是对输入的一连串是非判断,最后综合所有树的答案。
还有一些学习算法完全不需要输出。例如 K 均值[4] 把没有标签的样本分成 组,使同组的样本彼此相似。这称为无监督学习:算法在输入中寻找结构,但没有人告诉它正确答案。本课程主要讨论监督学习。
4. 特征,以及深度学习改变了什么
第 3 节的方法在输入是一小串有意义的数字时效果很好,照片却不是这样。图 1.1 中的图像是一个 的像素网格,每个像素有三个颜色值,合起来是 405,900 个数。单独一个数,比如第 20,000 个像素的亮度,几乎说明不了图里有没有猫。把猫往左挪一点,这串数字几乎全部改变,答案却不变。
几十年来的解决办法是先计算特征。特征是从原始输入计算出来的量,它让有用的信息更容易被利用,例如边缘的位置、某个区域的纹理、文档中某些词出现的次数。这些特征提取器由人来设计,学习算法再学习从特征到输出的映射(图 1.3 上)。整个系统的表现在很大程度上取决于人工设计的特征好不好,而设计特征需要对每类数据都有专门的知识。第 2 篇会详细介绍经典的图像特征。
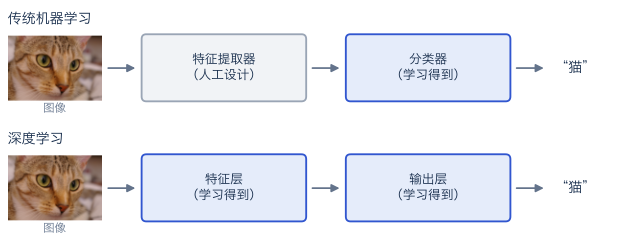
图 1.3 学习发生在哪里。 上:在传统机器学习中,特征提取器由人设计(灰色),只有最后的分类器从数据中学习(蓝色)。下:在深度学习中,计算特征的各层也和输出层一起从数据中学习。
深度学习去掉了人工设计这一环。深层神经网络是一长串简单计算,所有计算的参数都通过训练来确定(图 1.3 下)。网络的前几层最终会计算出某种特征,但这些特征是“有助于降低训练数据上误差”的那些,而不是由人事先决定的。对于图像、声音和文本这类难以手工设计好特征的数据,这种做法大幅提高了准确率 [5]。
特征由学习得到,并不意味着什么都不用设计。网络的结构、衡量误差的方式和训练数据仍然要由人来选择,而且这些选择非常重要。深度学习通常也比第 3 节的方法需要更多的数据和计算。对于小规模的表格数据,比如一张记录房屋属性的表,基于决策树的方法仍然很有竞争力。
5. 本课程的安排
每个监督学习系统都要回答四个问题,接下来的每一篇回答其中一个:
- 模型看到的是什么? 第 2 篇介绍特征,以及经典图像特征的计算方法。
- 在哪一族函数中搜索? 第 3 篇介绍神经网络。
- 怎样衡量模型错得有多厉害? 第 4 篇定义损失函数。
- 怎样找到好的参数? 第 5 篇介绍用梯度下降进行训练。
第 6 篇再讨论:怎样判断训练好的模型在从未见过的数据上表现如何。
小结
模型是把输入映射为输出的函数,参数从一族函数中选出其中一个。机器学习根据训练样本选择这些参数,而不是手工写出函数。传统方法学习最后的映射,但依赖人工设计的特征。深度学习连特征也一并学习,这在图像、声音和文本上效果尤其好,代价是需要更多的数据和计算。
注释
延伸阅读。 《Understanding Deep Learning》[1] 第 1 章概述了监督学习、无监督学习和强化学习,第 2 章更详细地讨论了第 2 节的直线模型。
名称的由来。 “回归”指预测一个连续的数值,比如价格;“分类”指预测一个类别。两者都属于监督学习,区别在于输出的类型。第 4 篇会说明,它们还需要不同的损失函数。
外推。 用第 0 到第 9 年的数据预测第 10 年属于外推:输入落在训练数据的范围之外。一般来说,模型在这种地方不如在训练样本之间可靠。第 6 篇会再谈到这一点。
练习
练习 1.1 用图 1.2 中的直线,模型对第 12 年的预测是多少?(答案:。)
练习 1.2 判断下列任务是回归还是分类,并说明输入和输出分别是什么:(a)根据照片估计一个人的年龄;(b)判断一封邮件是否是垃圾邮件;(c)预测明天的最高气温。
练习 1.3 一张灰度照片有 个像素,每个像素一个数。模型接收到多少个数?如果是彩色照片呢?(答案:307,200 和 921,600。)
参考文献
- 1: Simon J.D. Prince (2023). Understanding Deep Learning. MIT Press.
- 2: Corinna Cortes and Vladimir Vapnik (1995). Support-vector networks. Machine Learning 20, 273–297.
- 3: Leo Breiman (2001). Random forests. Machine Learning 45, 5–32.
- 4: Stuart Lloyd (1982). Least squares quantization in PCM. IEEE Transactions on Information Theory 28(2), 129–137.
- 5: Yann LeCun, Yoshua Bengio and Geoffrey Hinton (2015). Deep learning. Nature 521, 436–444.